Made in Germany, aber versteht die KI auch Pfälzisch?
Aleph Alpha, Kolibri 1 und die Frage, warum digitale Souveränität nicht beim Hochdeutschen enden sollte.
Deutschland möchte bei künstlicher Intelligenz souveräner werden. Eigene Modelle, eigene Infrastruktur, europäische Rechenzentren, Datenschutz, nachvollziehbare Trainingsverfahren und möglichst wenig Abhängigkeit von OpenAI, Google, Anthropic oder chinesischen Anbietern. Das ist verständlich und aus meiner Sicht auch richtig.
Mit Kolibri 1 hat Aleph Alpha aus Heidelberg im Oktober 2026 ein bemerkenswertes Modell veröffentlicht. 78 Milliarden Parameter, davon rund 3,46 Milliarden je Token aktiv, Mixture-of-Experts-Architektur, eine Kontextlänge von bis zu einer Million Tokens, offene Modellgewichte unter Apache 2.0 und ein klarer Schwerpunkt auf Deutsch und Englisch. Das Modell wurde nach Angaben von Aleph Alpha in Europa entwickelt und trainiert. [1] [2]
Damit lässt sich ziemlich gut über technologische Souveränität reden. [13]
Mich beschäftigt inzwischen aber eine andere Frage.
Wenn wir schon eine deutsche KI bauen – warum versteht sie Deutschland dann nicht auch sprachlich besser als die amerikanische Konkurrenz?
Und damit meine ich nicht, ob sie einen deutschen Geschäftsbericht zusammenfassen kann. Ich meine nicht, ob sie weiß, wie man „Aufmerksamkeitsdefizit-Hyperaktivitätsstörung“ korrekt tokenisiert. Und ich meine auch nicht, ob sie Verwaltungsdeutsch in Bulletpoints verwandeln kann.
Ich meine etwas wesentlich Alltäglicheres.
Was passiert, wenn ich mit der KI so rede, wie Menschen tatsächlich reden? [13]
Wenn ich Pfälzisch schreibe. Oder Schwäbisch. Fränkisch. Kölsch. Sächsisch. Platt. Saarländisch. Oder wenn jemand mit einer regionalen Färbung spricht und nicht mit dem Deutsch einer Nachrichtensprecherin.
Genau dort wird es plötzlich erstaunlich dünn.
Und je tiefer ich mich in die Forschung dazu eingelesen habe, desto mehr hatte ich den Eindruck, dass wir bei der Diskussion über eine „deutsche KI“ bisher möglicherweise an einem ziemlich interessanten Punkt vorbeireden. [13]
Was an Kolibri wirklich deutsch ist – und was nicht automatisch daraus folgt
Zunächst einmal lohnt es sich, bei Kolibri genauer hinzusehen, denn die häufig verkürzte Kritik „zu viel Englisch, zu wenig Deutsch“ wäre unfair.
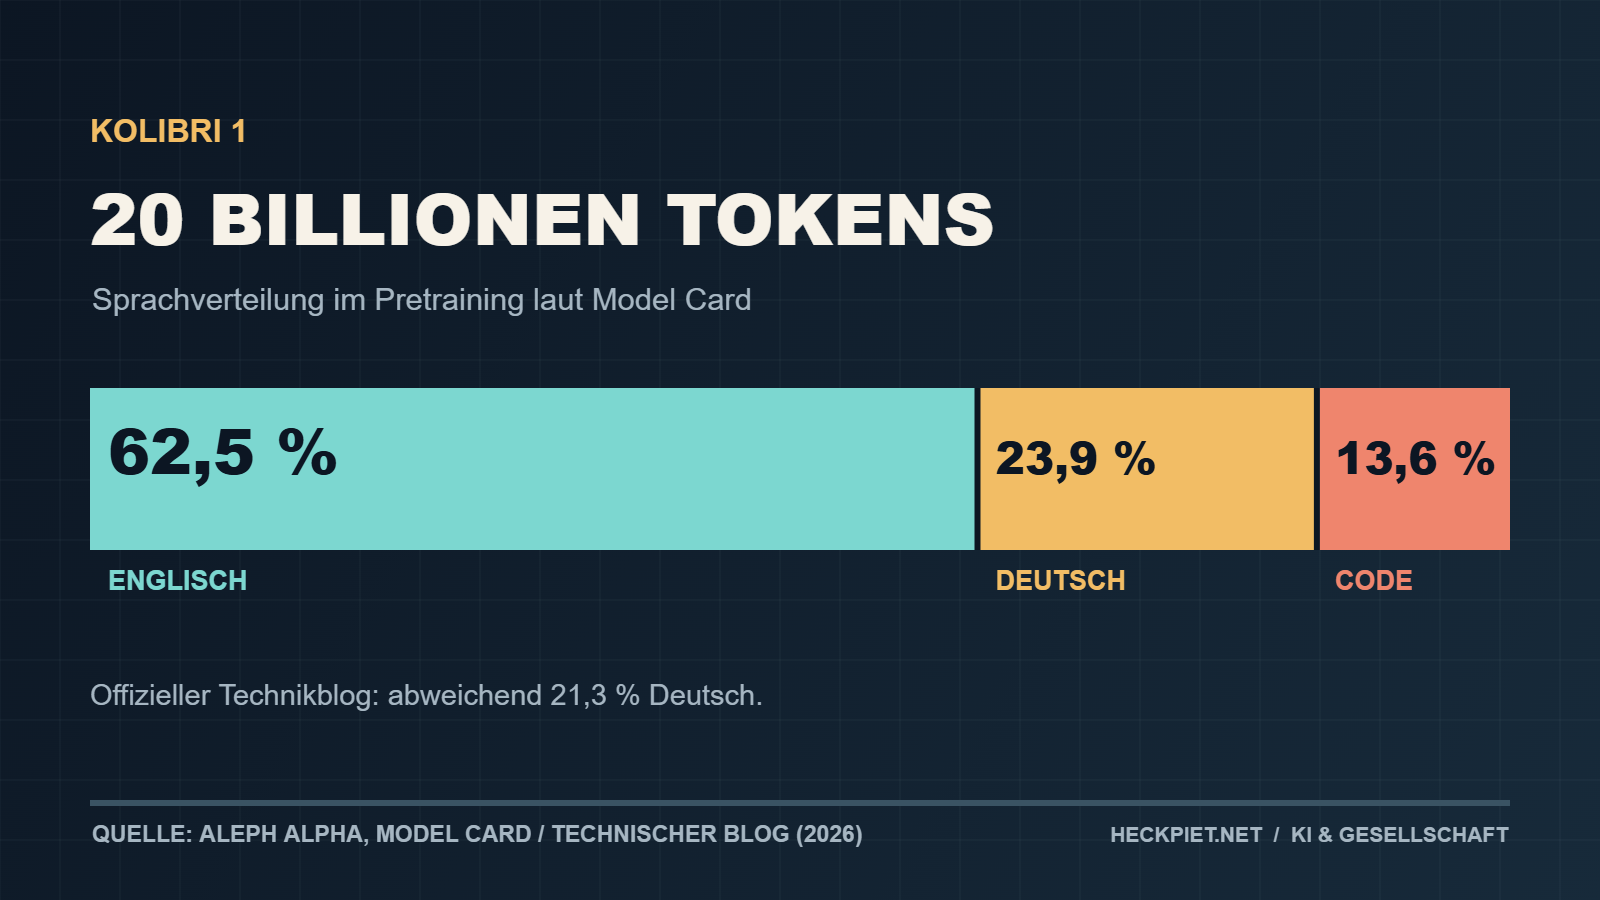
Die offizielle Model Card nennt für das Pretraining insgesamt 20 Billionen Tokens. Davon entfallen ungefähr 62,5 Prozent auf Englisch, 23,9 Prozent auf Deutsch und 13,6 Prozent auf Programmcode. Im offiziellen technischen Blog nennt Aleph Alpha für den deutschen Anteil wiederum 21,3 Prozent beziehungsweise rund 4,3 Billionen Tokens. Die veröffentlichten Angaben sind an dieser Stelle also nicht vollständig konsistent. Klar ist aber in beiden Fällen, dass Englisch den Datensatz deutlich dominiert. [1] [2]
Das wirkt zunächst merkwürdig.
Ein deutsches KI-Unternehmen baut ein Modell für deutsche Anwendungen und trainiert es trotzdem mehrheitlich mit englischen Texten.
Nur wäre es zu einfach, daraus direkt einen Fehler abzuleiten.
Aleph Alpha hat nach eigener Darstellung mit kleineren Testmodellen untersucht, welcher deutsche Datenanteil für die angestrebten Fähigkeiten sinnvoll ist und kam dabei auf ungefähr 20 Prozent. Gleichzeitig berichtet das Unternehmen, dass nach Bereinigung, Qualitätsfilterung und Entfernung von Duplikaten aus vorhandenen deutschen Datenquellen lediglich rund 390 Milliarden deutsche Tokens übrig blieben. Für das geplante Training wollte man aber ungefähr vier Billionen deutsche Tokens haben. [2]
Das ist eine ziemlich interessante Zahl.
Denn sie zeigt etwas, das in der Diskussion um nationale Sprachmodelle gerne unterschätzt wird.
Das Problem ist nicht einfach, dass niemand deutsche Texte ins Modell kippt. Das Problem ist, genügend hochwertige, vielfältige, rechtlich verwendbare und maschinenlesbare deutsche Texte zu bekommen.
Aleph Alpha hat deshalb eigene deutsche Webdaten aufbereitet und zusätzlich synthetische Inhalte erzeugt. In einer wissenschaftlichen Veröffentlichung von 2026 zeigt das Unternehmen außerdem, dass seine speziell kuratierte Sammlung „Aleph-Alpha-GermanWeb“ bei deutschen Benchmarks bessere Resultate liefert als FineWeb2 – selbst wenn FineWeb2 zusätzlich mit hochwertigen Quellen wie Wikipedia angereichert wird. Das ist ein wichtiger Befund für die Frage, ob man einem Modell einfach mehr Wikipedia geben muss. Offenbar nicht. Qualität, Auswahl und Datenaufbereitung spielen eine erhebliche Rolle. [3]
Aleph Alpha hat sogar ausdrücklich davor gewarnt, das Problem durch massenhafte Übersetzungen englischer Daten lösen zu wollen. Übersetzte Inhalte transportieren eben nicht automatisch deutsche kulturelle Kontexte. Ein amerikanischer Text über Schule, Behörden, Arbeitsleben oder Alltag wird nicht dadurch kulturell deutsch, dass man sämtliche Wörter übersetzt. Entsprechend wurden maschinelle Übersetzungen bei Kolibri nur begrenzt eingesetzt.
Das finde ich bemerkenswert, denn im Grunde steckt darin bereits genau die Argumentation, die ich beim Thema Dialekte weiterführen würde.
Wenn Aleph Alpha sagt, dass authentisch deutsche Texte wichtig sind, weil Übersetzungen kulturelle Eigenheiten nicht ausreichend wiedergeben, dann müsste der nächste Gedanke eigentlich lauten:
Was ist denn authentisch deutsch?
Ein FAZ-Artikel?
Ein Verwaltungsbescheid?
Die deutschsprachige Wikipedia?
Oder gehört dazu nicht ebenfalls, dass ein beträchtlicher Teil der Bevölkerung regional spricht und schreibt?
Genau dort endet die Optimierung bislang offenbar ziemlich abrupt.
Kolibri besitzt einen speziell für Deutsch und Englisch entwickelten Tokenizer. Das Unternehmen hat dabei ausdrücklich deutsche Morphologie und insbesondere zusammengesetzte Wörter berücksichtigt. [2]
Das ist technisch sinnvoll.
Aber eine KI, die „Kraftfahrzeughaftpflichtversicherung“ effizient verarbeitet, versteht deshalb noch lange nicht automatisch:
„Hoschd des jetzt gsehn oder hoschd widder net uffgebasst?“
Und schon gar nicht ist damit gesagt, dass sie weiß, ob jemand in Neustadt, Kaiserslautern, Ludwigshafen oder der Westpfalz denselben Satz überhaupt genauso schreiben würde.
Genau das macht das Thema wesentlich komplizierter – und interessanter.
Ausgerechnet Pfälzisch zeigt ziemlich gut, wo das Problem liegt
Ich habe mir deshalb Pfälzisch genauer angesehen.
Und da wird die Sache fast schon ironisch.
Denn wenn man den Eindruck bekommt, es gebe schlicht keine pfälzischen Sprachdaten, stimmt das so überhaupt nicht.
Das Pfälzische Wörterbuch gehört zu den umfangreichen wissenschaftlichen Dokumentationen regionaler deutscher Sprache. Sein Ziel war ausdrücklich nicht nur, einige lustige Dialektwörter zu sammeln. Erfasst wurden Wortschatz, Aussprache, Morphologie und Syntax sowie regionale Varianten. Das Forschungszentrum Deutscher Sprachatlas beschreibt das Werk als systematische Erfassung der pfälzischen Sprachlandschaft. Im digitalen REDE-System sind unter anderem 420 Karten des Pfälzischen Wörterbuchs aufbereitet. [4] [5] [13]
Über das Trierer Wörterbuchnetz ist das Material inzwischen digital erschlossen und mit anderen historischen und regionalen Wörterbüchern verknüpft. Die Universität Trier hebt sogar hervor, dass das Pfälzische Wörterbuch zu Beginn des Digitalisierungsprojektes besonders gut als Ausgangsbasis geeignet war, weil Teile bereits maschinenlesbar vorlagen. [4] [5]
Und dann gibt es seit 2024 tatsächlich einen Band aus dem Duden-Verlag mit dem schlichten Titel „Pfälzisch – Alla hopp un uffbasse“ von Michael Landgraf. [6]
Das Buch umfasst 128 Seiten und beschäftigt sich unter anderem mit regional unterschiedlichen Formen wie ich habb, ich häbb, ich hann und ich hunn, mit Grammatik, Lautwandel, Redewendungen und dem regionalen Wortschatz. [13]
Man könnte also sagen: Den „Pfälzer Duden“ gibt es inzwischen tatsächlich – zumindest als populären Sprach- und Kulturführer des Duden-Verlags.
Nur sollte man das nicht mit einem normativen Rechtschreibduden verwechseln.
Denn genau das wäre beim Pfälzischen auch ziemlich absurd.
Es gibt nicht das eine Pfälzisch.
Pfälzisch ist ein Sammelbegriff für unterschiedliche rheinfränkische Dialekte. Selbst innerhalb relativ kleiner Entfernungen verändern sich Wortschatz, Lautung und Formen. Schon der Duden-Band macht diese Unterschiede sichtbar. Das Pfälzische Wörterbuch dokumentiert die Variation noch wesentlich systematischer. [4] [5]
Das bedeutet für KI-Training etwas Entscheidendes.
Man kann einem Modell nicht einfach eine Liste mit 20.000 pfälzischen Wörtern geben und anschließend behaupten, es könne Pfälzisch.
Ein Wörterbuch vermittelt Wortbedeutungen.
Aber Sprache besteht nicht aus einem Sack voller einzelner Wörter.
Sprache besteht aus Satzbau, Kontext, Pragmatik, Aussprache, Redewendungen, Code-Switching, Humor, verkürzten Formen, regional unterschiedlichen Schreibweisen und der Frage, wann welcher Ausdruck überhaupt verwendet wird. [13]
Wenn ich einer KI erkläre, dass „dehääm“ ungefähr „daheim“ bedeutet, hat sie ein Wort gelernt.
Sie hat noch lange kein Sprachgefühl.
Genau dafür gibt es inzwischen einen beinahe perfekten wissenschaftlichen Beleg aus der unmittelbaren Nachbarschaft der Pfalz.
2026 veröffentlichten Forscher eine Studie über Meenzerisch, den Mainzer Dialekt. Sie digitalisierten dafür ein vorhandenes Wörterbuch mit 2.351 Dialektwörtern und ihren hochdeutschen Bedeutungen und testeten aktuelle große Sprachmodelle. Das beste Modell erreichte bei der korrekten Erklärung der Dialektwörter gerade einmal 6,27 Prozent Genauigkeit. Wenn die Modelle umgekehrt aus einer Definition das richtige Meenzerische Wort erzeugen sollten, lag das beste Resultat sogar nur bei 1,51 Prozent. Selbst mit Beispielen und zusätzlich extrahierten Sprachregeln blieben die Ergebnisse unter zehn Prozent. [7]
Das muss man sich einmal auf der Zunge zergehen lassen.
Wir reden über Sprachmodelle, die mathematische Aufgaben lösen, Programmcode schreiben und lange wissenschaftliche Texte analysieren können. [13]
Und dann kommt ein Mainzer mit einem Dialektwort um die Ecke und plötzlich ist Feierabend.
Das ist für mich eines der anschaulichsten Beispiele dafür, was „Low Resource“ im Jahr 2026 tatsächlich bedeutet.
Nicht unbedingt, dass überhaupt keine Daten existieren.
Sondern dass sie im Verhältnis zum restlichen Training nahezu kein Gewicht besitzen.
Und genau hier kommen wir zu einem Punkt, den ich für die Diskussion wesentlich spannender finde als die Frage, ob Kolibri nun 21,3 oder 23,9 Prozent Deutsch gesehen hat.
Warum die pfälzische Wikipedia allein das Problem nicht lösen wird
Pfälzisch besitzt sogar eine eigene Wikipedia.
Die pfälzische Sprachversion hat aktuell ungefähr 2.866 Artikel. Sie ist damit real vorhanden, aber verglichen mit den großen Sprachversionen winzig.
Könnte man nicht einfach sagen:
Perfekt. Rein damit ins Training. Dann lernt die KI eben Pfälzisch.
Leider funktioniert Sprachtraining nicht ganz so.
Zunächst ist Wikipedia sprachlich ein sehr spezielles Medium.
Enzyklopädische Texte handeln von Orten, Personen, Geschichte, Politik, Technik oder Kultur. Sie bilden aber nur eingeschränkt ab, wie Menschen im Alltag miteinander sprechen.
Niemand sitzt beim Schorletrinken und sagt:
„Die Stadt Neustadt an der Weinstraße ist eine kreisfreie Stadt in Rheinland-Pfalz mit einer Fläche von …“
Menschen sagen eher:
„Fahrschd heit noch no Neustadt?“
Das ist linguistisch ein völlig anderer Datentyp.
Das Problem wird dadurch verstärkt, dass Dialekte wie Pfälzisch keine allgemein verbindliche Orthografie besitzen. Ein Ausdruck kann von verschiedenen Autoren unterschiedlich geschrieben werden. Gerade diese Variation ist für ein Modell jedoch wichtig, wenn es tatsächliche Nutzereingaben verstehen soll. Dass nicht standardisierte Schreibweisen eine zentrale Herausforderung für Dialekt-NLP darstellen, zeigen zahlreiche aktuelle Arbeiten zu deutschen und schweizerdeutschen Dialekten.
Noch entscheidender ist aber die Größenordnung.
Kolibri wurde mit 20 Billionen Tokens vortrainiert. Eine Wikipedia mit weniger als 3.000 Artikeln kann darin nur einen mikroskopisch kleinen Anteil ausmachen, sofern sie nicht bewusst höher gewichtet oder mehrfach eingespeist wird. Die bloße Tatsache, dass ein Text theoretisch im Trainingskorpus vorhanden war, sagt deshalb noch ziemlich wenig darüber aus, wie stark er das Modell prägt. Das ist eine Schlussfolgerung aus den dokumentierten Trainingsgrößen und der Forschung zu gezielter Dialektanpassung.
Und hier liegt vermutlich auch ein Teil der Erklärung für die Mundartliteratur.
Es gibt zahlreiche ältere pfälzische Texte.
Wikisource führt beispielsweise pfälzische Mundartliteratur von Franz von Kobell, historische Sammlungen, Gedichte und Paul Münchs berühmte „Pälzisch Weltgeschicht“ auf. [9]
Paul Münch starb 1951. Nach deutschem Urheberrecht erlischt das Urheberrecht grundsätzlich siebzig Jahre nach dem Tod des Urhebers. Damit sind seine eigenen Werke grundsätzlich urheberrechtlich nicht mehr geschützt, wobei bei konkreten neueren Editionen zusätzliche Rechte an Bearbeitungen oder Ausgaben zu prüfen sein können. [9]
Das Material existiert also durchaus.
Historische Wörterbücher existieren.
Mundartliteratur existiert.
Die pfälzische Wikipedia existiert.
Regionalgeschichtliche Texte existieren.
Sprachwissenschaftliche Karten existieren.
Und auch Audioaufnahmen deutscher Dialekte existieren in erheblicher Menge.
Das Problem lautet deshalb zunehmend nicht mehr:
„Wo sollen wir überhaupt pfälzische Daten herbekommen?“
Die bessere Frage lautet:
„Wie machen wir daraus einen Datensatz, den ein modernes KI-Modell tatsächlich lernen kann?“
Genau diesen Punkt formulieren inzwischen auch deutsche Sprachwissenschaftler.
Das 2026 gegründete Netzwerk Regionale Sprache und Künstliche Intelligenz, koordiniert vom Forschungszentrum Deutscher Sprachatlas der Universität Marburg, beschreibt das Hauptproblem ausdrücklich nicht als völliges Fehlen von Sprachdaten. Es gebe durchaus große Bestände. Es fehle jedoch an ausreichend großen Mengen, die rechtssicher zugänglich, standardisiert, digitalisiert, hochwertig aufbereitet und für KI wiederverwendbar seien. Gefordert werden deshalb unter anderem systematische Sammlungen gesprochener Alltagssprache, saubere Metadaten, offene Lizenzen und die Digitalisierung historischer Bestände. [20]
Das ist ein entscheidender Unterschied.
Ein hundert Jahre altes Wörterbuch in einer Digitalbibliothek ist noch kein KI-Trainingsdatensatz.
Ein eingescanntes Mundartbuch ist noch kein sauber annotiertes Textkorpus.
Und zehn Stunden Dialektaufnahmen ohne Transkription sind für ein Sprachmodell nicht dasselbe wie zehn Stunden Audio mit exakten Transkriptionen, regionalen Metadaten, hochdeutschen Entsprechungen und Sprecherinformationen.
Wir besitzen Sprachschätze. Wir besitzen nur noch nicht überall die Datenpipeline, die daraus KI-Trainingsmaterial macht.
Bei gesprochener Sprache wird sichtbar, wie groß der Abstand noch ist
Besonders interessant wird es, wenn wir nicht nur über Text reden. [13]
Denn Dialekte sind traditionell vor allem gesprochene Sprache.
Und genau deshalb kann ein reines Textmodell wie Kolibri das Problem nur teilweise lösen.
Kolibri nimmt Text entgegen und erzeugt Text. Wer pfälzische Sprache direkt einsprechen möchte, benötigt davor ein Speech-to-Text-System. Soll die KI anschließend tatsächlich Pfälzisch sprechen, braucht man zusätzlich Text-to-Speech beziehungsweise ein Speech-Language-Modell.
Hier fällt auf, dass die Schweiz Deutschland momentan teilweise voraus ist.
Für Schweizerdeutsch existiert mit STT4SG-350 beispielsweise ein öffentlich beschriebenes Sprachkorpus mit rund 343 Stunden Sprachaufnahmen aus allen großen Schweizer Dialektregionen. Die Daten wurden ausdrücklich für Anwendungen wie Spracherkennung, Sprachsynthese, Dialekterkennung und Sprechererkennung entwickelt. [10]
Forscher der Universität Zürich haben außerdem untersucht, wie OpenAIs Whisper mit Schweizerdeutsch umgeht. [15]
Das Ergebnis ist interessant. Whisper kann Schweizerdeutsche Sprache teilweise erstaunlich gut verarbeiten, produziert dabei jedoch typischerweise eine Übertragung ins Standarddeutsche. Die Forscher kamen zu dem Ergebnis, dass Whisper als Schweizerdeutsch-ASR durchaus brauchbar ist, sofern genau diese standarddeutsche Ausgabe gewünscht ist. [15]
Das ist nützlich.
Aber es ist nicht dasselbe wie:
„Ich verstehe deinen Dialekt und bewahre ihn.“
Es bedeutet eher:
„Ich verstehe deinen Dialekt und mache Hochdeutsch daraus.“
Auch bei der Sprachausgabe passiert inzwischen einiges.
Forscher der ZHAW haben ein bestehendes XTTSv2-System gezielt mit Schweizerdeutschen Daten nachtrainiert und zeigen, dass Standarddeutscher Text dadurch in unterschiedliche Schweizer Dialekte als Sprache ausgegeben werden kann.
Noch weiter geht das 2026 gestartete beziehungsweise öffentlich vorgestellte Projekt SynthDiaSG von ZHAW und Universität Zürich. [16]
Hier soll die künstliche Stimme nicht lediglich irgendwie „Schweizerdeutsch“ sprechen. Die Forscher sammeln Sprachaufnahmen aus 85 Orten, um Modelle zu entwickeln, die lokale Unterschiede zwischen einzelnen Ortschaften wiedergeben können. Das ist genau die Art von Forschung, die ich mir auch für deutsche Dialekträume wünschen würde.
Denn es macht einen gewaltigen Unterschied, ob ich sage:
„Unsere KI kann Schweizerdeutsch.“
Oder ob ich sage:
„Unsere KI versteht, dass Zürich nicht Bern ist und Bern nicht Wallis.“
Genau dasselbe gilt für Pfälzisch.
„Pfälzisch“ als einzelnes Label wäre eigentlich bereits zu grob.
Ein wirklich gutes regionales System müsste wenigstens lernen, dass Vorderpfälzisch, Westpfälzisch, Kurpfälzisch und angrenzende rheinfränkische Formen nicht identisch sind.
In Deutschland entstehen dafür inzwischen bessere Grundlagen.
Das Projekt Betthupferl veröffentlichte 2025 einen Evaluationsdatensatz mit rund vier Stunden Dialektsprache aus fränkischen, bairischen und alemannischen Regionen sowie zusätzlichem Standarddeutsch. Er wurde ausdrücklich dafür geschaffen, die Robustheit von Spracherkennung und Dialekt-zu-Standarddeutsch-Systemen zu testen. [12]
2026 folgte Saar-Voice, ein sechs Stunden umfassendes Sprachkorpus für den Saarbrücker Dialekt, das unter anderem als Grundlage für zukünftige Dialekt-TTS-Systeme gedacht ist.
Besonders wichtig könnte aber ein anderes Projekt werden.
Die Deutsche Forschungsgemeinschaft fördert seit 2026 das GeoSpeech-Korpus, das ausdrücklich ein georeferenziertes Korpus deutscher Dialekte und Akzente für das KI-Training entwickeln soll. Ziel ist die Verbesserung regional sensibler Spracherkennung, Sprachassistenz und Dialekterkennung. [21]
Das passt hervorragend zu den bereits vorhandenen Ressourcen des Deutschen Sprachatlas.
Das REDE-Projekt hat moderne Sprachaufnahmen an rund 150 Orten in Deutschland erhoben. Die Aufnahmen berücksichtigen unterschiedliche Generationen und mehrere Gesprächssituationen vom intendierten Dialekt bis zu standardnäherer Aussprache und freien Gesprächen. Die Datenbank umfasst insgesamt 4.425 Aufnahmen, von denen zuletzt mehr als 2.500 linguistisch bearbeitet und durchsuchbar waren. [13]
Wenn man wissen möchte, wo eine deutsche Dialekt-KI ihre Daten herbekommen könnte, dann liegt ein Teil der Antwort also buchstäblich seit Jahren in deutschen Spracharchiven.
Wir müssten sie nur endlich so behandeln, als seien Sprachdaten eine strategische Infrastruktur.
Mehr Webseiten uff Pälzisch wären gut – aber sie wären nicht die eigentliche Lösung
Damit kommen wir zu der praktischen Frage.
Müssten wir jetzt anfangen, das Internet mit pfälzischen Webseiten zu füllen?
Meine Antwort wäre:
Ja. Aber bitte nicht mit der Vorstellung, dass Googlebot, Common Crawl oder irgendein KI-Unternehmen schon vorbeikommen wird und damit sei die Sache erledigt.
Mehr authentische digitale Sprache hilft.
Wenn Vereine, regionale Medien, Archive, Gemeinden, Kulturinstitutionen oder Privatpersonen Inhalte in Dialekt veröffentlichen, entstehen Daten, die vorher nicht vorhanden waren.
Noch wertvoller wären parallele Inhalte.
Also beispielsweise:
Pfälzischer Satz
Hochdeutsche Entsprechung
Region
Ort
Sprecheralter
gesprochene Aufnahme
phonetische Transkription
Bedeutung regionaler Ausdrücke
So etwas ist für Sprachmodelle Gold wert.
Eine weitere pfälzische Webseite über die Geschichte eines Dorfes wäre nett.
Ein Datensatz mit 50.000 authentischen pfälzischen Sätzen und ihren hochdeutschen Entsprechungen wäre aus KI-Sicht wahrscheinlich wesentlich interessanter.
Denn damit könnte man gezielt trainieren.
Genau dafür gibt es inzwischen mehrere technische Wege.
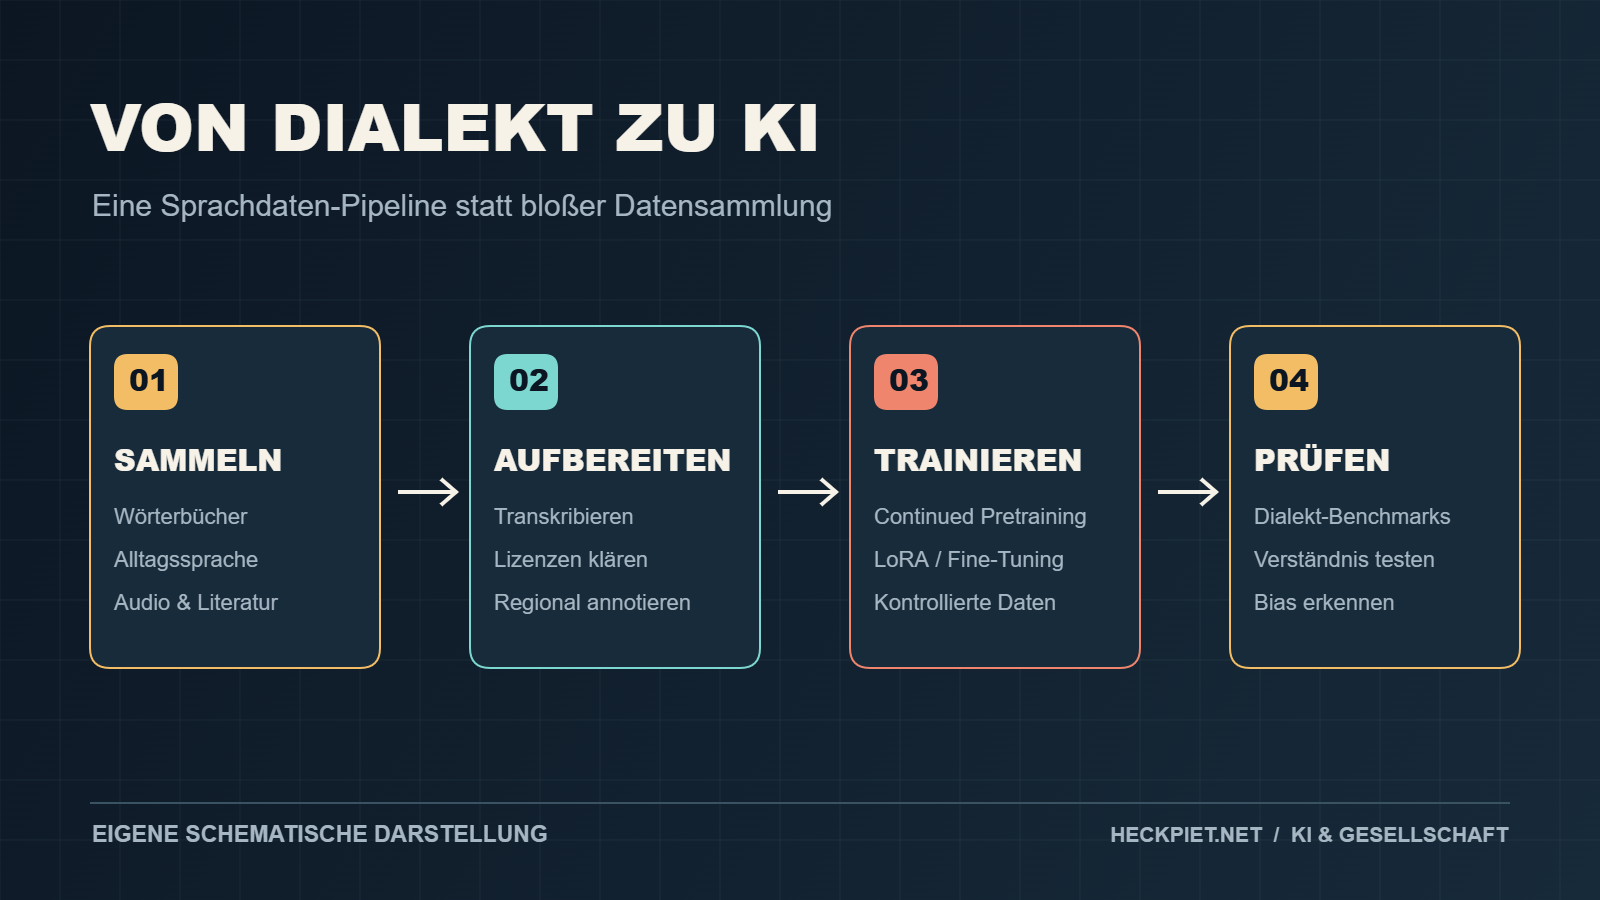
Continued Pretraining statt eines neuen Milliardenmodells
Man muss nicht Kolibri komplett neu trainieren.
Man könnte ein vorhandenes offenes Modell nehmen und es anschließend noch einmal gezielt auf großen Mengen authentischer regionaler Texte weitertrainieren.
Dieses Verfahren nennt sich Continued Pretraining. [17]
Bei Schweizerdeutsch wurde genau das bereits untersucht. Forscher adaptierten mehrsprachige Encoder durch weiteres Training auf Schweizerdeutschen Texten. Besonders interessant war, dass ein modularer Dialekt-Adapter 97,5 Prozent der Leistung einer vollständigen monolithischen Anpassung erreichte. [17]
Das bedeutet praktisch:
Für Pfälzisch müsste niemand ein neues 78-Milliarden-Parameter-Modell von null trainieren.
Man könnte Kolibri, Llama, Mistral, Qwen oder ein wesentlich kleineres Modell nehmen und ihm gezielt regionale Kompetenz hinzufügen.
Das wäre um Größenordnungen realistischer.
Fine-Tuning und LoRA
Noch günstiger sind Verfahren wie LoRA oder andere parameter-effiziente Anpassungen.
Hier wird nicht das gesamte Modell neu trainiert. Man verändert lediglich kleine zusätzliche Gewichtsmatrizen.
Eine 2026 veröffentlichte Untersuchung zur Dialektanpassung von Québec-Französisch zeigt, dass Continual Pretraining in Kombination mit solchen parameter-effizienten Methoden auch mit kleinen Datensätzen den Abstand zwischen Standardsprache und Dialekt verringern kann.
Das macht die Sache plötzlich ziemlich konkret.
Ein Pfalz-Adapter für ein offenes Sprachmodell wäre technisch keine Science-Fiction.
Das Problem wäre eher, einen vernünftigen Datensatz zusammenzustellen.
Wörterbücher als Ausgangspunkt
Auch Wörterbücher sind keineswegs nutzlos.
Im Gegenteil.
Forscher haben 2025 mit DiaLemma einen Datensatz von rund 100.000 manuell bestätigten deutsch-bairischen Wortpaaren aufgebaut. Die Arbeit zeigt gleichzeitig, wie wichtig es ist, Schreibvarianten systematisch zu berücksichtigen.
2026 zeigten dieselben Forschungsrichtungen, dass bei bestimmten Aufgaben zur automatischen Erstellung von Dialektlexika relativ einfache, spezialisierte Verfahren sogar besser funktionieren können als sehr große Sprachmodelle.
Das finde ich fast sympathisch.
Nicht jedes Sprachproblem braucht 100 Milliarden Parameter.
Manchmal braucht man einfach ein gutes Wörterbuch und jemanden, der weiß, was er damit macht.
Das Pfälzische Wörterbuch wäre deshalb keine fertige Lösung. [4] [5]
Aber es wäre ein hervorragender Grundbaustein.
Man könnte daraus Wortpaare, Bedeutungen, regionale Varianten, historische Formen und Beispielsätze extrahieren.
Zusammen mit Dialektliteratur, Wikipedia, modernen Texten und gesprochener Sprache würde daraus etwas entstehen, das wesentlich näher an einem echten Sprachkorpus liegt.
Synthetische Daten – aber nur mit Vorsicht
Auch künstlich erzeugte Dialektdaten könnten helfen.
Eine 2026 veröffentlichte Untersuchung zu deutschen Dialekten zeigt, dass synthetisch erzeugte Übersetzungspaare das Auffinden semantisch entsprechender Dialekt- und Standarddeutsch-Sätze erheblich verbessern können. Besonders LLM-generierte Trainingsdaten lieferten dort starke Verbesserungen. [18]
Das ist verlockend.
Man nimmt beispielsweise 100.000 hochdeutsche Alltagssätze, lässt ein gutes Modell mehrere pfälzische Varianten erzeugen und trainiert anschließend damit ein kleineres Modell.
Nur lauert hier ein hübsches Henne-Ei-Problem.
Wenn das große Modell Pfälzisch bereits schlecht kann, erzeugt es möglicherweise KI-Pfälzisch.
Also Texte, die so aussehen, wie sich ein Sprachmodell Pfälzisch vorstellt.
Viel „isch“.
Viel „uff“.
Ein paar „Weck, Worscht un Woi“.
Fertig.
So kann man sich hervorragend einen synthetischen Dialekt bauen, den außerhalb des Rechenzentrums niemand spricht.
Auch neuere Forschung zu synthetischen Trainingsdaten warnt davor, dass Verzerrungen eines Ausgangsmodells durch künstliche Daten weitergegeben oder sogar verstärkt werden können.
Deshalb wären Muttersprachler beziehungsweise echte Dialektsprecher entscheidend.
Nicht unbedingt, um jeden Satz selbst zu schreiben.
Aber um synthetische Daten zu überprüfen.
RAG hilft – aber macht aus einem Modell keinen Dialektsprecher
Eine weitere Möglichkeit wäre Retrieval-Augmented Generation.
Man könnte einer KI das Pfälzische Wörterbuch, regionale Literatur und eine Dialektdatenbank als Wissensquelle zur Verfügung stellen. [4] [5]
Dann könnte sie bei unbekannten Begriffen nachschlagen.
Das wäre sinnvoll.
Aber RAG löst das grundsätzliche Sprachproblem nicht vollständig.
Wenn das Modell einen pfälzischen Satz bereits falsch segmentiert oder missversteht, weiß es möglicherweise gar nicht, wonach es suchen soll.
RAG kann Wissen nachliefern.
Sprachgefühl muss weitgehend im Modell oder in einer vorgeschalteten spezialisierten Sprachkomponente stecken.
Das ist der Unterschied zwischen einem Touristen, der bei jedem zweiten Wort im Wörterbuch nachschlägt, und jemandem, der die Sprache tatsächlich spricht.
Vielleicht braucht Deutschland gar nicht die größte KI – sondern die deutscheste
Je länger ich mich mit dem Thema beschäftige, desto mehr verändert sich für mich die ursprüngliche Kritik an Aleph Alpha.
Am Anfang dachte ich:
Warum hat eine deutsche KI so viele englische Trainingsdaten?
Inzwischen halte ich diese Frage fast für die falsche.
Denn der hohe englische Anteil ist technisch erklärbar. Wer Programmierung, internationale Wissenschaft, Mathematik und weltweites Wissen abdecken möchte, wird um große Mengen englischer Daten kaum herumkommen. Aleph Alpha zeigt zudem selbst, dass es sich intensiv mit hochwertigen deutschen Trainingsdaten beschäftigt.
Meine Kritik wäre deshalb inzwischen eine andere.
Ich erwarte von einer deutschen KI nicht, dass sie weniger Englisch kann. Ich erwarte, dass sie mehr Deutschland versteht.
Und das ist etwas anderes.
Ich möchte nicht zwangsläufig ein Modell, dessen Trainingsdaten zu 90 Prozent deutsch sind.
Ich hätte lieber ein Modell, das erkennt, dass „Unn?“ in der Pfalz eine vollständige Gesprächseröffnung sein kann.
Das versteht, dass ein Dialektsprecher nicht weniger intelligent ist, nur weil sein Satz nicht dem hochdeutschen Standard entspricht.
Und genau dieser letzte Punkt ist leider keineswegs theoretisch.
Eine 2025 auf der EMNLP veröffentlichte Studie untersuchte mehrere große Sprachmodelle mit sieben deutschen Dialektgruppen, darunter auch rheinfränkische Dialekte, zu denen Pfälzisch gehört. Die Modelle verbanden Dialektsprecher systematisch häufiger mit negativen Eigenschaften und übertrugen diese Verzerrungen teilweise sogar auf modellbasierte Entscheidungen. [19]
Damit wird Dialekt plötzlich zu mehr als einem Komfortproblem.
Wenn KI irgendwann Bewerbungen bewertet, Bürgeranfragen vorsortiert, Kundenkommunikation analysiert oder Bildungssysteme unterstützt, dann ist es eben nicht egal, ob regionale Sprache schlechter verstanden oder sogar mit bestimmten sozialen Eigenschaften verbunden wird.
Das Problem könnte sogar größer werden, wenn wir es nicht messen.
Die üblichen Benchmarks fragen Mathematik, Allgemeinwissen, Coding und logisches Schlussfolgern ab.
Sie fragen kaum:
Versteht dieses Modell einen Saarländer?
Einen Pfälzer?
Eine 75-jährige Frau aus der Westpfalz?
Einen Jugendlichen, der Hochdeutsch, Dialekt und Internet-Slang innerhalb eines Satzes mischt?
Und solange solche Dinge nicht in Benchmarks auftauchen, können Modelle problemlos den nächsten Rekordwert erreichen, ohne dass jemand merkt, dass ein Teil ihrer Nutzer sprachlich schlicht schlechter bedient wird.
Genau deshalb finde ich die Mainzer Untersuchung so spannend.
Sie macht aus einem diffusen Gefühl eine messbare Aufgabe.
2.351 Dialektbegriffe. [7]
Definitionen.
Generierung.
Klare Trefferquoten.
Und plötzlich sieht man schwarz auf weiß, dass die Modelle an einer Aufgabe scheitern, die ein Mensch aus der Region möglicherweise ohne nachzudenken erledigt.
Warum sollte Aleph Alpha daraus nicht einen Vorteil machen?
Kolibri könnte beispielsweise eigene regionale Benchmarks bekommen.
Pfälzisch.
Schwäbisch.
Fränkisch.
Bairisch.
Kölsch.
Sächsisch.
Plattdeutsch.
Nicht nur mit einzelnen Wörtern, sondern mit echten Alltagssituationen.
Eine Bürgeranfrage.
Ein Gespräch in einer Werkstatt.
Eine WhatsApp-Nachricht.
Ein Arztgespräch.
Eine Wegbeschreibung.
Ein Streit.
Ein Witz.
Eine regionale Redewendung. [13]
Und dann misst man nicht, ob das Modell besonders lustig Dialekt imitieren kann.
Man misst zuerst etwas viel Wichtigeres.
Hat es verstanden, was der Mensch wollte?
Danach kann man prüfen, ob es angemessen darauf antworten kann.
Und erst ganz am Ende würde ich testen, ob es selbst authentisch Dialekt erzeugen kann.
Denn eine KI, die „Pälzisch schwätze“ kann, aber den Pfälzer nicht versteht, wäre technologisch ungefähr so sinnvoll wie ein Tourist mit Trachtenhut, der drei regionale Sprüche auswendig gelernt hat.
Das wäre Folklore.
Keine Sprachkompetenz.
Vielleicht liegt genau darin eine interessante strategische Chance für europäische KI.
Die USA verfügen über deutlich größere Kapitalmärkte, Hyperscaler und Trainingsbudgets.
China ebenfalls.
Europa wird diesen Wettbewerb wahrscheinlich nicht dadurch gewinnen, dass wir dasselbe Modell bauen, nur sechs Monate später und etwas kleiner.
Aber wir könnten Modelle entwickeln, die bestimmte europäische Anforderungen besser verstehen.
Unsere Verwaltung.
Unsere Rechtsräume.
Unsere Unternehmen.
Unsere Sprachen.
Und eben auch unsere regionalen Sprachvarianten.
Das wäre digitale Souveränität, die ein Nutzer tatsächlich bemerkt.
Nicht weil das Rechenzentrum 300 Kilometer näher steht.
Sondern weil die Maschine ihn versteht.
Was ich aus der Recherche mitnehme
Meine ursprüngliche Vermutung hat sich nur teilweise bestätigt.
Pfälzisch fehlt nicht deshalb in KI-Systemen, weil es keinerlei Daten gibt.
Im Gegenteil.
Wir haben ein wissenschaftlich erarbeitetes Pfälzisches Wörterbuch. Wir haben digitalisierte Dialektwörterbücher. Wir haben eine pfälzische Wikipedia. Wir haben Mundartliteratur, zum Teil inzwischen gemeinfrei. Wir haben jahrzehntealte Spracharchive und moderne Tonaufnahmen. Und inzwischen entstehen sogar explizit KI-taugliche deutsche Dialektkorpora. [4] [5]
Was fehlt, ist die Verbindung.
Die Daten müssen digitalisiert, lizenziert, normalisiert, annotiert und so zusammengestellt werden, dass Modelle sie tatsächlich lernen können. Genau diesen Handlungsbedarf formuliert auch das 2026 gegründete Netzwerk Regionale Sprache und Künstliche Intelligenz. [20]
Und anschließend müssen diese Daten im Training überhaupt genügend Gewicht erhalten.
Das ist vielleicht der wichtigste Punkt.
Ein Text kann im Trainingsdatensatz vorhanden sein und für das Ergebnis trotzdem praktisch bedeutungslos sein.
Wenn einige Millionen Dialekttokens gegen Billionen standardsprachliche und englische Tokens antreten, hat der Dialekt zwar theoretisch am Training teilgenommen.
Praktisch wurde er aber möglicherweise überrollt.
Die Lösung lautet deshalb nicht einfach „mehr Daten“.
Sie lautet:
mehr authentische Daten,
mehr gesprochene Daten,
mehr regionale Variation,
bessere Metadaten,
saubere Paralleltexte zwischen Dialekt und Hochdeutsch,
gezieltes Continued Pretraining, [17]
gegebenenfalls LoRA-Adapter für Regionen,
sinnvoll kontrollierte synthetische Daten
und vor allem eigene Benchmarks, mit denen überhaupt sichtbar wird, ob sich etwas verbessert. Forschung zu Schweizerdeutsch, deutschen Dialekten und anderen Low-Resource-Varianten zeigt inzwischen, dass solche gezielten Anpassungen funktionieren können, ohne ein Grundmodell komplett neu trainieren zu müssen.
Und vielleicht braucht es tatsächlich auch mehr Webseiten uff Pälzisch.
Nicht weil 500 neue Vereinswebseiten plötzlich Kolibri umprogrammieren würden.
Sondern weil Sprache digital existieren muss, damit sie langfristig überhaupt Teil der KI-Welt werden kann.
Noch besser wäre allerdings, wenn wir nicht darauf warten würden, dass irgendwelche Webcrawler zufällig über diese Inhalte stolpern.
Warum baut Rheinland-Pfalz nicht gemeinsam mit Universitäten, Bibliotheken, dem SWR, regionalen Archiven, Heimatvereinen und freiwilligen Dialektsprechern ein offenes Pfälzisch-Korpus für KI?
Texte.
Audio.
Transkriptionen.
Historische Literatur.
Moderne Alltagssprache.
Vorderpfalz.
Westpfalz.
Kurpfalz.
Saarpfalz.
Junge Sprecher.
Alte Sprecher.
Formelle Sprache.
Kneipengespräch.
WhatsApp-Stil.
Und alles mit sauber geklärten Nutzungsrechten.
Die Schweiz zeigt mit ihren Dialektprojekten bereits ziemlich eindrucksvoll, dass so etwas möglich ist.
Vielleicht wäre das sogar sinnvoller, als noch den 37. KI-Hub mit einem schicken Logo zu eröffnen.
Denn am Ende entscheidet sich technologische Souveränität für mich nicht allein daran, wem die GPUs gehören.
Sie entscheidet sich auch daran, welche Teile unserer Gesellschaft in den Daten überhaupt vorkommen.
Kolibri 1 ist deshalb für mich kein schlechtes Beispiel einer deutschen KI.
Im Gegenteil.
Gerade weil Aleph Alpha bei deutschen Trainingsdaten, Tokenisierung und kultureller Übersetzungsproblematik bereits ungewöhnlich tief gearbeitet hat, wäre das Unternehmen eigentlich ein ziemlich guter Kandidat, den nächsten Schritt zu gehen.
Von einer deutschen KI wünsche ich mir nicht, dass sie sich künstlich von der Welt abschottet.
Sie soll Englisch können.
Sie soll programmieren können.
Sie soll internationale Wissenschaft verstehen.
Aber wenn sie „Made in Germany“ auf die Verpackung schreibt, darf ich vielleicht auch erwarten, dass Deutschland darin ein bisschen mehr vorkommt als DSGVO, DIN-Normen und Verwaltungsdeutsch.
Deutschland klingt eben nicht überall wie Tagesschau.
Und die Pfalz schon gar nicht.
Eine souveräne deutsche KI sollte deshalb nicht weniger Englisch lernen. Sie sollte endlich mehr Deutsch lernen.
Und zwar das Deutsch, das tatsächlich gesprochen wird.
Alla hopp.
Quellen und Referenzen
- Aleph Alpha (2026): Kolibri 1 – Model Card. https://huggingface.co/Aleph-Alpha/Kolibri-1
- Aleph Alpha (2026): Kolibri Has Landed: A Sovereign Open-Weight Model. https://aleph-alpha.com/en/blog/kolibri-has-landed-a-sovereign-open-weight-model/
- Burns, Thomas F. et al. (2026): Aleph-Alpha-GermanWeb: Improving German-language LLM pre-training with model-based data curation and synthetic data generation. https://aclanthology.org/2026.eacl-long.58/
- Forschungszentrum Deutscher Sprachatlas: Pfälzisches Wörterbuch im REDE-SprachGIS. https://regionalsprache.de/pfwb.aspx
- Trier Center for Digital Humanities: Digitaler Verbund von Dialektwörterbüchern. https://tcdh.uni-trier.de/de/projekt/digitaler-verbund-von-dialektwoerterbuechern
- Landgraf, Michael (2024): Pfälzisch – Alla hopp un uffbasse, Dudenverlag. https://shop.duden.de/Pfaelzisch/9783411756872
- Bui et al. (2026): Meenz bleibt Meenz, but Large Language Models Do Not Speak Its Dialect. https://aclanthology.org/2026.lrec-1.258/
- Blaschke et al. (2024): MaiBaam: A Multi-Dialectal Bavarian Universal Dependency Treebank. https://aclanthology.org/2024.lrec-main.953/
- Bundesministerium der Justiz: § 64 Urheberrechtsgesetz – Allgemeines. https://www.gesetze-im-internet.de/urhg/__64.html
- Plüss et al. (2023): STT4SG-350: A Speech Corpus for All Swiss German Dialect Regions. https://aclanthology.org/2023.acl-short.150/
- ETH Zürich: SwissDial Dataset. https://mtc.ethz.ch/publications/open-source/swiss-dial.html
- Blaschke et al. (2025): A Multi-Dialectal Dataset for German Dialect ASR and Dialect-to-Standard Speech Translation. https://www.isca-archive.org/interspeech_2025/blaschke25_interspeech.html
- Fischer und Lameli (2026): German Dialects Across Situations, Generations, and Regions: The REDE Corpus as an Oral Resource for NLP. https://aclanthology.org/events/dialres-2026/
- DFG (2026): Datenkorpora für Künstliche Intelligenz: DFG fördert 51 Projekte. https://www.dfg.de/de/aktuelles/neuigkeiten-themen/info-wissenschaft/2026/ifw-26-75
- Dolev, Lutz und Aepli (2024): Does Whisper Understand Swiss German? An Automatic, Qualitative, and Human Evaluation. https://aclanthology.org/2024.vardial-1.3/
- ZHAW: Synthetic Dialectology of Swiss German (SynthDiaSG). https://www.zhaw.ch/de/forschung/projekt/80522
- Vamvas, Aepli und Sennrich (2024): Modular Adaptation of Multilingual Encoders to Written Swiss German Dialect. https://aclanthology.org/2024.moomin-1.3/
- Wang, Plank und Litschko (2026): Bi-Text Mining across German Dialects: On the Role of Synthetic Training Data for Dialect Adaptation. https://aclanthology.org/2026.bucc-1.9/
- Bui et al. (2025): Large Language Models Discriminate Against Speakers of German Dialects. https://aclanthology.org/2025.emnlp-main.415/
- Philipps-Universität Marburg (2026): Wie die KI Dialekte lernen kann. https://www.uni-marburg.de/de/aktuelles/news/2026/wie-die-ki-dialekte-lernen-kann
- DFG / Forschungszentrum Deutscher Sprachatlas (2026): GeoSpeech-Korpus – Ein georeferenziertes Korpus deutscher Dialekte und Akzente für das KI-Training. https://juser.fz-juelich.de/record/1062798