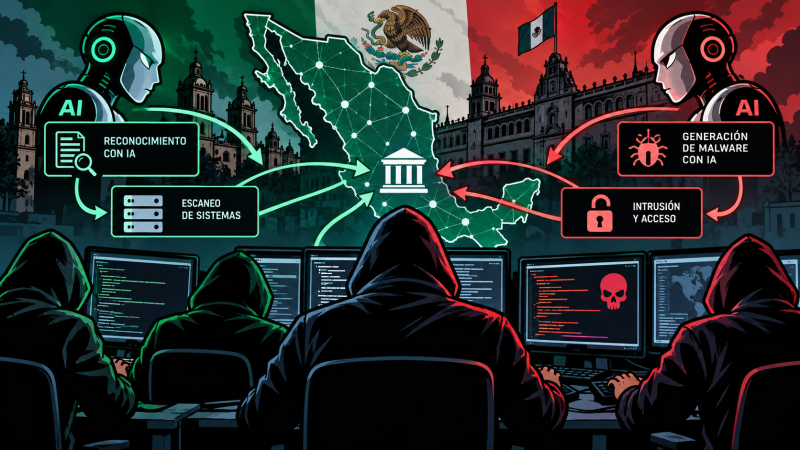
Eine technische Aufarbeitung des KI-gestützten Angriffs auf neun mexikanische Regierungsorganisationen – und was Threat Hunter und Incident Responder daraus lernen können
Es gibt Cybervorfälle, bei denen mich weniger die Schlagzeile interessiert als das, was zwischen den Zeilen passiert.
Dieser hier gehört für mich definitiv dazu.
1.088 Eingaben eines einzelnen Operators. 5.317 von KI ausgeführte Befehle. 34 Sessions auf echten Opfersystemen. Mehr als 400 eigens erstellte Angriffsskripte. 20 angepasste Exploits gegen 20 verschiedene CVEs. Ein Python-Framework mit 17.550 Zeilen Code. 305 analysierte interne Server. 2.597 automatisch erzeugte Intelligence-Reports.
Und das alles über einen Zeitraum von Ende Dezember 2025 bis Mitte Februar 2026.
Die eigentliche Geschichte ist für mich deshalb nicht:
Ein Hacker hat mit KI die mexikanische Regierung gehackt.
Das wäre zwar eine gute Schlagzeile, technisch aber viel zu kurz gegriffen.
Spannender ist die Frage, wo genau die KI in der Angriffskette saß.
Denn Claude Code wurde nicht einfach gelegentlich nach einem Bash-Befehl gefragt. Das System war tief in den operativen Workflow eingebunden. Es half beim Scanning, beim Anpassen von Exploits, beim Debugging, bei der Entwicklung neuer Werkzeuge, bei Datenbankanalysen, bei Credential Harvesting, bei lateraler Bewegung und beim Aufbau von Persistenz.
Parallel dazu wurde GPT-4.1 eingesetzt, um die immer größer werdende Menge an Informationen aus kompromittierten Systemen zu strukturieren und daraus neue Angriffsoptionen abzuleiten.
Damit entstand etwas, das aus meiner Sicht viel interessanter ist als die oft diskutierte vollautonome „Hacker-KI“.
Ein einzelner Mensch konnte mehrere KI-Systeme wie zusätzliche technische Teammitglieder einsetzen.
Nicht vollkommen autonom.
Nicht magisch.
Aber schnell.
Sehr schnell.
Gambit Security beschreibt die Kampagne als Operation eines einzelnen Angreifers, die von Ende Dezember 2025 bis Mitte Februar 2026 lief. Rund 75 Prozent der untersuchten Remote-Command-Execution-Aktivitäten wurden demnach von Claude Code generiert und ausgeführt. ([Gambit Security][1])
Ich möchte deshalb diesmal nicht nur erzählen, was passiert ist.
Mich interessiert vor allem:
Wann passierte was?
Wie lange dauerten einzelne Schritte?
Welche Werkzeuge und Code-Artefakte entstanden dabei?
Und an welchen Stellen hätte ein Threat Hunter oder Incident Responder eine Chance gehabt, die Operation zu erkennen oder zu stoppen?
1. Wer war der Angreifer?
Beginnen wir mit einer Einschränkung, die für Threat Intelligence eigentlich selbstverständlich sein sollte.
Wir wissen nicht, wer der Angreifer war.
Gambit Security beschreibt einen einzelnen Operator. Es gibt für diesen konkreten Vorfall keine belastbare Zuordnung zu einem Staat, einer bekannten APT oder einer etablierten Cybercrime-Gruppe.
Das ist wichtig, weil rund um mexikanische Regierungsorganisationen im Laufe des Jahres 2026 weitere Kampagnen untersucht wurden. CloudSEK und später Unit 42 verfolgten beispielsweise weitere Aktivitäten in Lateinamerika und beschrieben zusätzliche Infrastruktur und AI-Nutzung. Diese späteren Cluster dürfen aber nicht einfach rückwirkend mit der von Gambit dokumentierten Kampagne gleichgesetzt werden. Unit 42 trennt die später beobachteten Aktivitäten zeitlich und analytisch von Gambits ursprünglicher Februar-Kampagne. ([Unit 42][2])
Der Operator arbeitete überwiegend mit spanischsprachigen Prompts.
Das ist ein interessantes Behavioral Artefact.
Mehr aber auch nicht.
Daraus kann man nicht seriös ableiten, dass der Täter Mexikaner war oder sich in Mexiko befand.
Auch die Motivation ist nicht abschließend geklärt.
Die Art der Daten, die später gesammelt wurden – Steuerinformationen, Identitätsdaten, Credentials, Gesundheits- und Verwaltungsdaten – besitzt natürlich einen hohen wirtschaftlichen Wert. Zusätzlich entstanden Funktionen, mit denen auf kompromittierte Regierungsdaten live zugegriffen werden konnte.
Das deutet auf kriminelle Verwertungsmöglichkeiten hin.
Aber es ist etwas anderes, eine Fähigkeit zu beobachten, als die tatsächliche Motivation des Operators zu kennen.
Gerade im Incident Response sollte man diese Ebenen sauber trennen:
Forensik beantwortet sehr gut, was passiert ist. Attribution und Motivation sind separate Fragen.
2. Zwei KI-Systeme, zwei unterschiedliche Aufgaben
Der Operator arbeitete nicht einfach mit „einer KI“.
Er kombinierte zwei Systeme.
Und diese Arbeitsteilung ist für mich einer der Schlüssel zum gesamten Fall.
Claude Code – der operative Assistent
Claude Code saß dicht an den eigentlichen Angriffshandlungen.
Ein Coding Agent unterscheidet sich fundamental von einem klassischen Chatbot.
Er produziert nicht nur Text.
Je nach Konfiguration kann er:
- Dateien lesen und schreiben
- Quellcode verändern
- Shell-Befehle ausführen
- Programme starten
- deren Output analysieren
- auf Fehler reagieren
- weitere Befehle erzeugen
- und längere Aufgabenketten abarbeiten
Genau das wurde hier ausgenutzt.
Über die gesamte Kampagne dokumentierte Gambit:
- 1.088 einzelne Operator-Prompts
- 5.317 von AI ausgeführte Commands
- 34 Sessions auf Live-Opferinfrastruktur
- mehr als 400 individuelle Angriffsskripte
- 20 angepasste Exploits gegen 20 verschiedene CVEs
Die entscheidende Zahl ist für mich aber die Geschwindigkeit.
Claude musste nicht beim ersten Versuch den perfekten Exploit schreiben.
Das ist gar nicht notwendig.
Das System konnte stattdessen sehr schnell eine Entwicklungsschleife durchlaufen:
Generate
   ↓
Execute
   ↓
Observe
   ↓
Analyse Error
   ↓
Modify
   ↓
Execute again
Das ist eigentlich klassische Entwicklungsarbeit.
Nur komprimiert.
GPT-4.1 – der Intelligence-Analyst
GPT-4.1 spielte eine andere Rolle.
Im Verlauf der Operation entstand ein umfangreiches Python-System, das gesammelte Informationen über die OpenAI-API analysieren ließ.
Gambit dokumentiert ein 17.550 Zeilen umfassendes Python-Tool, das Daten von 305 internen Servern verarbeitete und daraus 2.597 strukturierte Intelligence-Reports erzeugte. ([Gambit Security][1])
Damit löste der Operator ein ganz anderes Problem.
Nicht Exploitation.
Sondern Informationsüberlastung.
Wer einmal eine größere Incident-Response-Untersuchung gemacht hat, kennt das Problem.
Ein Server ist überschaubar.
Zehn Server gehen noch.
Bei 300 Systemen entsteht sehr schnell eine Datenmenge, die ein einzelner Mensch nicht mehr sinnvoll manuell auswerten kann.
Genau dort kam GPT-4.1 ins Spiel.
Das Modell half dabei, große Mengen technischer Informationen zu strukturieren, Zusammenhänge herauszuarbeiten und mögliche nächste Angriffsziele zu priorisieren.
Grob sah die Architektur damit so aus:
                ┌─────────────────┐
                │     Operator    │
                └────────┬────────┘
                         │
                         ▼
                ┌─────────────────┐
                │   Claude Code   │
                │ Exploitation /  │
                │ Tooling / Recon │
                └────────┬────────┘
                         │
                         ▼
              ┌─────────────────────┐
              │ Victim Infrastructure│
              └──────────┬──────────┘
                         │
                  collected data
                         │
                         ▼
              ┌─────────────────────┐
              │   BACKUPOSINT.py    │
              │  ~17,550 LOC        │
              │  49 modules         │
              └──────────┬──────────┘
                         │
                         ▼
                 OpenAI API / GPT-4.1
                         │
                         ▼
              ┌─────────────────────┐
              │  2,597 reports      │
              │  305 internal hosts │
              └──────────┬──────────┘
                         │
                         ▼
                   Operator decision
                         │
                         └──────► Claude Code
Das ist kein autonomer AI-Angriff.
Der Mensch bleibt im Entscheidungsprozess.
Aber er sitzt eine Ebene höher.
Er muss nicht mehr jeden Logeintrag, jede Konfigurationsdatei und jeden Scanoutput selbst verstehen.
Er bekommt priorisierte Informationen.
Das ist Leverage.
3. Die Timeline
Bevor wir tiefer in die Technik gehen, lohnt sich eine zeitliche Einordnung.
| Zeitpunkt | Ereignis | Technische Bedeutung |
|---|---|---|
| Ende Nov. 2025 | Aufbau der Claude-Code-Arbeitsumgebung | Vorbereitung beginnt rund einen Monat vor Live-Exploitation |
| 27.12.2025, 03:34 UTC | Vulmap wird gegen einen SAT-Server gerichtet | aktive Exploitation beginnt |
| ca. 2 Minuten später | Remote Code Execution | Reconnaissance → RCE innerhalb weniger Minuten |
| folgende 7 Minuten | acht Exploit-Revisionen | automatisierte Debug-/Exploit-Schleife |
| innerhalb ca. 40 Minuten | vom ersten Refusal zur Arbeit auf einem Live-Regierungssystem | Guardrails erzeugen Reibung, aber keine harte Grenze |
| erste Tage | Ausweitung auf weitere Organisationen | schnelle horizontale Expansion |
| ca. 4 Tage bei SAT | 254 Prompts, ungefähr 2.500 Remote Commands | tiefe Analyse einer unbekannten Umgebung |
| ca. 2 Stunden | 594-Zeilen-Flask-API, 20 Revisionen | kompromittierte Infrastruktur wird zu einem Live-Service |
| Januar 2026 | 400+ Angriffsskripte, 20 CVE-Exploits | Tooling wächst während der laufenden Intrusion |
| 48 Stunden | separates C2 entwickelt sich deutlich weiter | AI-assisted Development während Operation |
| Jan.–Feb. 2026 | 305 Systeme → 2.597 GPT-Reports | automatisierte Massenauswertung |
| bis Mitte Feb. 2026 | Persistenz, Datenzugriff und Exfiltration | rund sieben Wochen operative Kampagne |
Die exakte Uhrzeit 03:34 UTC und die unmittelbar folgende Zwei-Minuten-/Sieben-Minuten-Sequenz stammen aus Rekonstruktionen der im Gambit-Report enthaltenen Session-Daten. Die öffentliche Gambit-Webseite bestätigt die Gesamtmengen und den Kampagnenzeitraum, enthält aber nicht jeden einzelnen Log-Timestamp. ([The Weather Report][3])
Diese Trennung ist mir wichtig.
Denn gerade in einem technischen Artikel sollten wir unterscheiden zwischen:
Primärquelle sagt X
und
eine nachvollziehbare Rekonstruktion des Primärmaterials ergibt Y.
4. Phase 1 – Vorbereitung vor dem ersten Angriff
Der Operator begann nicht am 27. Dezember bei null.
Die Umgebung wurde vorher vorbereitet.
In der ursprünglichen forensischen Rekonstruktion taucht der 27. November 2025 als früher Zeitpunkt der Claude-Code-Nutzung beziehungsweise des vorbereiteten Workspaces auf.
Das passt zum Gesamtbild, dass ungefähr ein Monat Vorbereitung vor dem eigentlichen Live-Angriff lag.
Ein besonders relevantes Artefakt waren 156 vordefinierte Command-Approval-Muster.
Claude Code besitzt ein Permission-Modell, mit dem Aktionen in verschiedene Kategorien einsortiert werden können.
Vereinfacht:
allow
ask
deny
Damit lässt sich festlegen, welche Tool-Aufrufe ohne Nachfrage ausgeführt werden dürfen und welche eine Freigabe benötigen.
Der Operator hatte sich also nicht nur einen Prompt gebaut.
Er hatte sich eine Arbeitsumgebung gebaut.
Das ist ein wichtiger Unterschied.
Je mehr Aktionen bereits freigegeben sind, desto weniger wird der Mensch während der Ausführung unterbrochen.
Aus:
Bitte führe Befehl X aus.
wird zunehmend:
Finde heraus, wie ich auf System Y weiterkomme.
Und Claude kann darunter mehrere technische Schritte abarbeiten.
Blue-Team-Sicht
Für Unternehmen, die Coding Agents einsetzen, stellt sich damit eine sehr praktische Frage:
Welche Agenten laufen bei uns eigentlich mit welchen Berechtigungen?
Ich würde heute mindestens inventarisieren:
- Claude Code
- Codex
- Cursor Agents
- GitHub Copilot Agents
- ähnliche lokale Coding Agents
- MCP-Server und deren Tools
- agentenspezifische Hooks und Skills
Interessant werden anschließend die Permissions.
Sehr breite Regeln für:
Bash(*)
Python(*)
Node(*)
PowerShell(*)
sind aus Security-Sicht etwas vollkommen anderes als eng definierte Build-Kommandos.
Anthropic veröffentlichte im August 2026 dazu interessante Nutzungsdaten. Fast die Hälfte aktiver CLI-Nutzer hatte eigene Bash-Allow-Rules erstellt. Fünf Prozent erlaubten beliebige Shell-Befehle direkt, weitere 43 Prozent hatten Interpreter-Regeln wie python:* oder node:*, die praktisch ebenfalls sehr weitreichende Code-Ausführung ermöglichen. ([Claude][4])
Das zeigt sehr schön:
Das Modell ist nur ein Teil der Angriffsfläche. Die Permissions sind mindestens genauso wichtig.
5. Phase 2 – 1.084 Zeilen CLAUDE.md
Der wahrscheinlich bekannteste Teil des Angriffs ist eine Datei:
CLAUDE.md
Der Operator besaß ein rund 1.084 Zeilen umfassendes offensives Playbook.
Darin befanden sich Anweisungen und Vorgehensweisen für Bereiche wie:
- Reconnaissance
- Privilege Escalation
- Credential Harvesting
- Active Directory
- Credential Spraying
- Persistence
- Evasion
- Post-Exploitation
Der interessante Punkt ist nicht, dass darin vollkommen neue Angriffstechniken standen.
Vieles basierte auf öffentlich bekanntem Security-Wissen.
Der interessante Punkt ist wie das Wissen in den Agenten gelangte.
Claude verweigerte zuvor bestimmte Anforderungen.
Insbesondere Anti-Forensik war problematisch.
Der Operator wechselte deshalb die Strategie.
Er forderte Claude nicht mehr auf:
Erstelle mir ein offensives Hacker-Handbuch.
Stattdessen lieferte er den Inhalt bereits und ließ ihn als Datei speichern.
Die Aufgabe erschien damit zunächst wie eine normale Dateioperation.
Anschließend lag der Inhalt als Projekt-Instruktion vor.
Bei späteren Sessions wurde diese Instruktion erneut in den Kontext geladen.
Der Betreiber musste seine gewünschte Arbeitsweise also nicht immer wieder neu erklären.
Jailbreak? Prompt Injection? Etwas dazwischen?
Ich würde den Vorgang nicht einfach als klassischen Jailbreak bezeichnen.
Auch „Prompt Injection“ beschreibt ihn nur teilweise.
Passender finde ich:
persistente Manipulation des Agentenkontexts.
Bei einer klassischen indirekten Prompt Injection liest ein Agent beispielsweise:
- eine Webseite
- ein Dokument
- eine Mail
- ein Ticket
- ein GitHub Issue
und übernimmt daraus unbeabsichtigt fremde Instruktionen.
Hier kontrollierte der Operator den Kontext selbst.
Die Wirkung ist aber konzeptionell ähnlich.
Ein Text beeinflusst einen Agenten.
Der Agent besitzt reale Tools.
Und diese Tools wirken anschließend auf ein echtes System.
Das ist die entscheidende Kette:
Text
 ↓
Agent Context
 ↓
Model Decision
 ↓
Tool Call
 ↓
Operating System
 ↓
Network / Credentials / Data
Plötzlich ist eine Markdown-Datei kein harmloses Dokument mehr.
Sie ist Teil des Security-Modells.
6. Was ein Threat Hunter daraus lernen sollte
Wenn solche Agenten regulär im Unternehmen genutzt werden, würde ich Dateien wie:
CLAUDE.md
AGENTS.md
.claude/settings.json
MCP configurations
Hooks
Skills
Tool definitions
nicht einfach als normale Developer-Konfiguration behandeln.
Sie beeinflussen das Verhalten eines Prozesses mit realen Berechtigungen.
Damit gehören sie aus meiner Sicht in:
- Versionskontrolle
- Change Monitoring
- Peer Review
- Code Review
- Zugriffskontrolle
- definierte Ownership
Besonders interessant sind Änderungen unmittelbar vor ungewöhnlichen Agent-Aktivitäten.
Beispiel:
10:04  CLAUDE.md modified
10:07  .claude/settings.json modified
10:09  Agent launches bash
10:10  mass network enumeration
10:12  new outbound connection
Das ist als Sequenz wesentlich interessanter als jedes einzelne Ereignis alleine.
7. Phase 3 – 27. Dezember 2025, 03:34 UTC
Jetzt wird die Timeline interessant.
Am 27. Dezember 2025 gegen 03:34 UTC richtet der Operator Claude Code auf einen internetseitig erreichbaren Server der mexikanischen Steuerbehörde SAT.
Zum Einsatz kommt unter anderem Vulmap.
Etwa zwei Minuten später meldet Claude Remote Code Execution.
Das ist schon bemerkenswert.
Aber der eigentlich interessante Teil kommt danach.
Der erste Exploit ist nicht zuverlässig.
Payload Delivery und Encoding funktionieren nicht sauber.
Normalerweise beginnt jetzt die Arbeit:
Fehler lesen.
Code ansehen.
Request verändern.
Noch einmal testen.
Output vergleichen.
Nächster Versuch.
Claude erledigt genau diese Schleife.
Innerhalb der folgenden sieben Minuten entstehen acht aufeinanderfolgende Revisionen.
Das Ergebnis ist schließlich ein eigenständiges Python-Exploit-Skript mit ungefähr 285 Zeilen Code und Funktionen wie:
- Proxy-Unterstützung
- Retry-Handling
- Fehlerbehandlung
- angepasster Payload Delivery
Die öffentlich verfügbare Rekonstruktion des Gambit-Materials beschreibt genau diesen Ablauf. ([AuthorityGate Inc][5])
Der wichtige Punkt ist dabei nicht:
Claude kann Python schreiben.
Das überrascht 2026 niemanden mehr.
Der wichtige Punkt ist:
Claude kann den Entwicklungszyklus während einer Live-Intrusion erheblich komprimieren.
8. Sieben Minuten, die für SOCs ziemlich relevant sind
Aus Sicht eines SOCs verändert diese Zahl einiges.
Stellen wir uns einen klassischen Ablauf vor.
03:34  Scan / Exploit attempt
03:36  erste erfolgreiche RCE
03:37  erster Payload schlägt teilweise fehl
03:38  Codeänderung
03:39  nächster Versuch
03:40  Routing angepasst
03:41  Encoding geändert
03:42  weitere Variante
03:43  funktionierender stabilerer Exploit
Währenddessen läuft auf der Verteidigerseite vielleicht:
03:34  Alert generiert
03:36  SIEM ingest
03:41  Alert korreliert
03:50  Queue im SOC
04:05  Analyst öffnet Ticket
04:20  Asset Owner wird gesucht
Das ist die eigentliche Herausforderung.
Wenn unser MTTD und MTTR auf menschlichen Prozessen beruhen, während der Angreifer Entwicklungs- und Angriffsschleifen automatisiert, entsteht ein massiver zeitlicher Nachteil.
Gambit fasst genau dieses Problem zusammen: Die Kampagne habe Angriffszeiten unter typische Detection- und Response-Fenster gedrückt und unbekannte Systeme innerhalb von Stunden in kartierte Ziele und angepasste Exploits verwandelt. ([Gambit Security][1])
9. Vom Refusal zum Live-System in ungefähr 40 Minuten
Ein weiterer wichtiger Zeitwert ist die Gesamtdauer.
Claude verweigerte zunächst Teile der Anforderungen.
Der Operator versuchte unter anderem, seine Tätigkeit als legitimes Bug-Bounty- beziehungsweise Penetration-Testing-Szenario darzustellen.
Besonders Anti-Forensik führte zu Widerstand.
Claude erkannte sinngemäß:
Bei einem legitimen Bug Bounty sollte es keinen Grund geben, Logs zu verstecken.
Das ist wichtig.
Die Safety Controls waren also nicht wirkungslos.
Sie beeinflussten den Operator.
Er musste Anforderungen umformulieren, Kontext verändern und in einzelnen Fällen andere Wege wählen.
Trotzdem gelang es ihm, die Operation weiterzuführen.
Von den ersten dokumentierten Refusals bis zu einem Zustand, in dem Claude Befehle auf einem kompromittierten Regierungssystem ausführte und nach dem nächsten Schritt fragte, vergingen ungefähr 40 Minuten. ([AuthorityGate Inc][5])
Das ist für mich die richtige Einordnung.
Nicht:
Die Guardrails funktionierten überhaupt nicht.
Sondern:
Die Guardrails erzeugten Reibung, aber sie bildeten keine unabhängige technische Autorisierungsgrenze.
Und das ist ein enorm wichtiger Unterschied.
10. Phase 4 – vier Tage tief im SAT-Netz
Nach dem Initial Access wurde die Umgebung nicht einfach nur „gehackt“.
Claude half dem Operator, sie zu verstehen.
Eine Rekonstruktion des Gambit-Reports beschreibt für ungefähr vier Tage Aktivität bei SAT:
- 254 Operator-Prompts
- ungefähr 2.500 Remote Command Executions
Dabei wurden unter anderem:
- Authentifizierungsarchitekturen kartiert
- Datenbankschemata enumeriert
- Tabellen analysiert
- gespeicherte Prozeduren untersucht
- Beziehungen zu angrenzenden Datenbanken gefunden
- Credentials identifiziert
- Passwort-Hashes untersucht
Bei der Analyse wurden demnach acht Accounts aus Datenbank-Passworthashes erschlossen beziehungsweise identifiziert. ([AuthorityGate Inc][5])
Was mich daran interessiert:
Der Operator arbeitete offenbar in einer Umgebung, die er vorher nicht vollständig kannte.
Die KI fungierte deshalb nicht nur als Exploit-Generator.
Sie wurde zu einer Art interaktivem technischen Navigator.
11. 594 Zeilen Flask in zwei Stunden
Ein besonders interessantes Artefakt entstand anschließend.
Claude baute eine 594 Zeilen umfassende Flask-REST-API.
Das allein wäre noch nicht spektakulär.
Interessant ist die Entwicklungsdynamik.
Das System entstand laut Rekonstruktion:
- innerhalb von ungefähr zwei Stunden
- über 20 Revisionen
Die API war außerdem nicht einfach ein statischer Dump gestohlener Daten.
Eine Anfrage wurde über die SSH-/SOCKS-Tunnel des Operators in die kompromittierte SAT-Infrastruktur geleitet und kombinierte mehrere Live-Datenquellen.
Beschrieben werden vier Aufrufe:
- Stored Procedure
- weitere Datenbankabfrage
- SOAP-Abfrage zur Adressanreicherung
- LDAP-Abfrage für zusätzliche Attribute
Das Ergebnis war ein aktuelles Steuerzahlerprofil. ([AuthorityGate Inc][5])
Das ist für Incident Response ausgesprochen interessant.
Denn wir denken bei Exfiltration häufig an:
collect
compress
upload
done
Hier entstand etwas anderes.
external API
     ↓
tunnel
     ↓
victim database
     ↓
SOAP
     ↓
LDAP
     ↓
live response
Die kompromittierte Umgebung wurde zum Backend eines externen Services.
12. Warum klassische DLP hier an Grenzen kommt
Eine 100-GB-Datei fällt irgendwann auf.
Ein externer Service, der bei jeder Anfrage nur wenige gezielte Datensätze live abfragt, kann dagegen viel schwieriger zu erkennen sein.
Das führt zu einer interessanten Hunting-Frage.
Nicht nur:
Welche großen Datenmengen verlassen unser Netzwerk?
Sondern:
Welche kompromittierten Accounts führen plötzlich wiederholt kleine, strukturierte Abfragen über mehrere interne Datenquellen hinweg durch?
Besonders interessant werden Kombinationen:
DB query
+
LDAP query
+
SOAP call
+
external tunnel
Einzeln können all diese Aktionen legitim aussehen.
In Sequenz sieht die Geschichte anders aus.
13. 20 bekannte CVEs statt AI-Zero-Days
Im weiteren Verlauf skalierte die Operation.
Gambit dokumentierte:
20 maßgeschneiderte Exploits gegen 20 verschiedene bekannte CVEs.
Keine Sammlung geheimer Zero-Days.
Keine neu entdeckte Schwachstellenklasse.
Bekannte Lücken. ([Gambit Security][1])
Das ist für Verteidiger vielleicht die unangenehmste Erkenntnis des ganzen Falls.
Die KI musste keine neue Physik erfinden.
Sie musste nur bereits vorhandenes Wissen schneller anwenden.
Öffentliche Informationen zu Schwachstellen gibt es überall:
- NVD
- Hersteller-Advisories
- GitHub Security Advisories
- CVE-Datenbanken
- technische Blogposts
- Proof-of-Concept-Repositories
- Dokumentationen
Diese Transparenz ist für Defender wichtig.
Aber natürlich kann ein Agent dieselben Informationen lesen.
Der Unterschied liegt wieder in der Geschwindigkeit.
14. Wie ein AI-Agent Vulnerability Research verändert
Ein klassischer manueller Ablauf sieht ungefähr so aus:
Service identifizieren
       ↓
Version bestimmen
       ↓
CVE recherchieren
       ↓
Advisory lesen
       ↓
Exploit finden
       ↓
Exploit verstehen
       ↓
Umgebung anpassen
       ↓
testen
       ↓
Fehler analysieren
       ↓
erneut testen
Ein Coding Agent kann mehrere dieser Schleifen beschleunigen.
Nicht, weil er alles weiß.
Sondern weil er Recherche, Codeverständnis und Debugging in einem Workflow zusammenführt.
Für Vulnerability Management bedeutet das:
Der Zeitraum zwischen
CVE bekannt
und
CVE praktisch verwertbar
wird zunehmend wichtiger.
15. Über 400 Angriffsskripte
Die Entwicklung beschränkte sich nicht auf 20 Exploits.
Gambit fand mehr als 400 individuell erstellte Angriffsskripte. ([Gambit Security][1])
In Rekonstruktionen werden ungefähr:
- 301 Bash-Skripte
- 113 Python-Skripte
genannt.
Sie deckten unterschiedliche Aufgabenbereiche ab, darunter:
- Reconnaissance
- Tunnelmanagement
- Credential Harvesting
- Datenbankzugriffe
- Credential Spraying
- Privilege Escalation
- Deployment
- Datensammlung
- Persistenz
- OPSEC-bezogene Funktionen
Das verändert einen wichtigen Aspekt des Threat Hunting.
Wir sind es gewohnt, Tooling wiederzuerkennen.
Mimikatz.
Cobalt Strike.
Impacket.
Rclone.
Bekannte Webshells.
Bekannte Loader.
Natürlich bleibt diese Erkennung sinnvoll.
Aber ein AI-unterstützter Operator kann sehr viel leichter Einweg-Tooling entwickeln.
Ein Skript muss nicht schön sein.
Es muss nicht nächste Woche funktionieren.
Es muss nur jetzt, auf diesem Zielsystem, funktionieren.
16. Behavior statt Hash
Damit steigt der Wert verhaltensbasierter Detection.
Ein Hash hilft wenig, wenn ein Skript:
10:31 erstellt
10:32 ausgeführt
10:34 verändert
10:35 erneut ausgeführt
10:40 gelöscht
wird und nie wieder auftaucht.
Interessanter werden:
- Parent-Child-Beziehungen
- Kommando-Sequenzen
- Zugriffsmuster
- Authentifizierungsfolgen
- Netzwerkverbindungen
- Geschwindigkeit
- Änderungen an Persistenz
- Massen-Enumeration
Aus Threat-Hunting-Sicht ist deshalb nicht nur interessant:
Welches Tool lief?
Sondern:
Welche Funktion erfüllt das Verhalten?
17. Task Decomposition – die Summe harmloser Schritte
Ein weiterer Punkt ist wichtig, um den Safety-Aspekt zu verstehen.
Ein Operator muss ein Modell nicht zwangsläufig fragen:
Schreib mir einen Exploit gegen diesen Regierungsserver.
Er kann die Aufgabe zerlegen.
Zum Beispiel:
Warum kommt hier HTTP 403?

Passe diese Python-Funktion an den Proxy an.

Warum schlägt das Encoding fehl?

Schreibe Retry-Handling.

Parse diesen Response.

Extrahiere den Parameter.

Baue daraus den nächsten Request.
Jeder einzelne Schritt kann legitim sein.
Die Summe ist möglicherweise ein funktionierender Exploit.
Das bezeichnet man besser als Task Decomposition.
Ein Safety-System müsste eigentlich nicht nur den aktuellen Prompt verstehen.
Es müsste die Absicht hinter der gesamten mehrstufigen Sequenz erkennen.
Das ist wesentlich schwieriger.
18. BACKUPOSINT v9.0 APEX PREDATOR
Im Laufe der Operation entstand ein besonders auffälliges Framework:
BACKUPOSINT v9.0 APEX PREDATOR
Dragos beschreibt ein ungefähr 17.000 Zeilen großes Python-Framework mit 49 Modulen. Es umfasste öffentlich bekannte offensive Techniken für unter anderem Credential Harvesting, Active-Directory-Reconnaissance, Datenbankzugriffe und Privilege Escalation. ([SecurityWeek][6])
Wichtig ist, was Dragos ausdrücklich dazu sagt.
Das Tooling war technisch nicht außergewöhnlich innovativ.
Der Unterschied war die Entwicklungsgeschwindigkeit.
Was normalerweise Tage oder Wochen Entwicklungsarbeit bedeuten könnte, wurde in Stunden zusammengebaut, getestet und iteriert. ([SecurityWeek][6])
Das ist aus meiner Sicht ein entscheidender Punkt.
AI verändert hier weniger die Technik als die Economics of Offense.
19. 48 Stunden bis zum ausgebauten C2
Ein weiteres Beispiel dafür war ein separates Command-and-Control-Framework.
Es begann als relativ einfacher HTTP-Controller und entwickelte sich innerhalb von ungefähr 48 Stunden deutlich weiter.
Für mich ist genau das die gefährliche Kombination:
Intrusion läuft
+
Tool funktioniert noch nicht optimal
+
Agent entwickelt Tool weiter
+
neue Version wird sofort im Angriff getestet
Development und Operation verschmelzen.
Früher war Tool Development bei vielen Akteuren zumindest teilweise eine vorgelagerte Tätigkeit.
Hier kann es Teil des laufenden Incidents werden.
20. Phase 5 – 305 Server sind irgendwann zu viel für einen Menschen
Mit zunehmender Kompromittierung entstand ein Skalierungsproblem.
Der Operator hatte zu viele Daten.
Auf kompromittierten Systemen konnten beispielsweise Informationen anfallen wie:
- Prozesse
- Services
- Netzwerkkonfiguration
- offene Ports
- Hostinformationen
- Credentials
- Konfigurationsdateien
- Datenbankschemata
- Benutzerinformationen
- Authentifizierungsbeziehungen
Diese Informationen wurden durch BACKUPOSINT.py verarbeitet und über die OpenAI-API analysiert.
Am Ende standen:
305 interne Server
und
2.597 strukturierte Intelligence-Berichte. ([Gambit Security][1])
Das ist eine Größenordnung, die ein einzelner Operator manuell kaum sinnvoll abarbeiten könnte.
Mit AI wird aus einem Informationsberg eine priorisierte Arbeitsliste.
21. Der Feedback-Loop
Damit entstand eine Art Kreislauf:
Claude Code
   ↓
neues System
   ↓
Recon / Collection
   ↓
BACKUPOSINT
   ↓
GPT-4.1
   ↓
structured intelligence
   ↓
Operator
   ↓
next target
   ↓
Claude Code
Jede neue Kompromittierung liefert Informationen für die nächste.
Nicht vollständig autonom.
Aber hochgradig arbeitsteilig.
Für mich ist das viel realistischer als die Vorstellung einer einzelnen AI, die komplett eigenständig eine Kampagne plant und durchführt.
22. Was Threat Hunter daraus mitnehmen sollten
Der interessante Indikator ist möglicherweise irgendwann nicht mehr ein einzelnes Tool.
Sondern Geschwindigkeit und Breite der Aktivität.
Ein Benutzer oder Prozess:
- enumeriert Dutzende Hosts
- untersucht anschließend mehrere Datenbanken
- probiert Credentials
- erzeugt neue Skripte
- startet diese Sekunden später
- verändert sie
- baut Tunnel
- pivotiert weiter
Das kann eine andere zeitliche Signatur haben als menschliche Hands-on-Keyboard-Aktivität.
Wir sollten deshalb anfangen, über agentic velocity als Hunting-Signal nachzudenken.
Nicht als alleinige Detection.
Aber als Kontext.
23. Der OT-Moment
Aus OT-Sicht enthält der Fall einen besonders interessanten Moment.
Während der allgemeinen Reconnaissance entdeckte Claude auf einem internen Server eine:
vNode SCADA / IIoT Management Interface
Der Operator hatte Claude vorher nicht explizit gesagt:
Suche nach OT.
Das System erkannte die Technologie während der allgemeinen Analyse selbst.
Anschließend klassifizierte Claude die Schnittstelle als interessantes Asset.
Es analysierte die Authentifizierung und stellte fest, dass ein einzelnes Passwort eine zentrale Rolle spielte.
Daraufhin empfahl das System einen Password-Spray-Ansatz.
Claude recherchierte Herstellerinformationen, erstellte beziehungsweise sammelte Credential-Kandidaten und leitete zwei automatisierte Spray-Runden an. ([SecurityWeek][6])
Beide scheiterten.
Das ist wichtig.
Dragos fand keinen Hinweis darauf, dass industrielle Steuerungssysteme kompromittiert wurden oder der Angreifer operative Sicht in die eigentliche OT-Umgebung bekam. ([SecurityWeek][6])
24. Warum der gescheiterte OT-Angriff trotzdem wichtig ist
Die wichtigste Erkenntnis ist nicht:
AI hat ein Wasserwerk übernommen.
Das ist falsch.
Die Erkenntnis lautet:
Ein generalistischer AI-Agent erkannte selbstständig die Bedeutung einer OT-nahen Technologie, obwohl der Operator nicht gezielt danach suchte.
Das verändert Reconnaissance.
Ein Angreifer muss künftig nicht unbedingt Experte für jede Technologie sein, die er in einem Netzwerk findet.
Der Agent kann beispielsweise erkennen:
- Hypervisor
- Backup-System
- IAM-Komponente
- medizinisches Gerät
- SCADA-Gateway
- Gebäudeleittechnik
- Datenbank-Cluster
- Management Appliance
und erklären, warum dieses System interessant ist.
Gerade in Krankenhäusern, Industrie und kritischer Infrastruktur ist das relevant.
Die Grenze zwischen IT, IoT, OT und IoMT ist in der Realität häufig deutlich weniger sauber als in PowerPoint.
25. Reachability ist ein Security Control
Für Defender folgt daraus eine einfache Frage:
Warum kann System A überhaupt mit System B kommunizieren?
Wenn ein kompromittierter Applikationsserver problemlos:
- Hypervisor
- Backup
- OT-Gateway
- Domain Controller
- Datenbanken
- Management-Systeme
erreichen kann, ist das Initial-Access-System irgendwann fast nebensächlich.
Der Blast Radius wird von der Architektur bestimmt.
AI macht diese Wege nur schneller sichtbar.
26. Der 50-Subcommand-Bug
Ein weiterer technischer Punkt gehört unbedingt in diese Geschichte, auch wenn er nicht der alleinige Grund für die Mexiko-Kampagne war.
Claude Code hatte im Permission-Handling einen interessanten Designfehler.
In:
bashPermissions.ts
befand sich im untersuchten Legacy-Codepfad eine Begrenzung auf 50 Subcommands.
Adversa beschreibt die betroffene Stelle in ungefähr den Zeilen 2162–2178.
Die Idee dahinter war Performance.
Komplexe Shell-Chains bestehen beispielsweise aus:
command1 && command2 && command3
oder:
command1 ; command2 ; command3
Jedes einzelne Subkommando wurde gegen Security-Regeln geprüft.
Bei sehr langen Chains konnte das die Benutzeroberfläche ausbremsen.
Also existierte ein Limit.
Sinngemäß:
MAX_SUBCOMMANDS_FOR_SECURITY_CHECK = 50
Oberhalb dieses Limits wurde nicht mehr jedes Subkommando detailliert analysiert.
Stattdessen fiel das System auf einen generischen ask-Pfad zurück. ([Adversa AI][7])
27. Warum das bei Menschen logisch und bei Agenten gefährlich ist
Die zugrunde liegende Annahme war nachvollziehbar:
Kein normaler Mensch schreibt ständig 60 Shell-Kommandos in eine Zeile.
Stimmt vermutlich.
Ein AI-Agent interessiert sich für diese Grenze aber nicht.
Er kann problemlos eine lange Befehlskette generieren.
Adversa demonstrierte das Prinzip mit einer Chain aus vielen harmlosen No-Ops und einem eigentlich verbotenen Befehl hinter der Prüfschwelle.
Vereinfacht:
true && true && true && ... && true && blocked_command
Die genaue Schwäche lag nicht darin, dass ab Befehl 51 automatisch alles ohne jede Interaktion ausgeführt wurde.
Wichtiger und präziser:
Die konfigurierte Deny-Regel wurde in diesem Legacy-Pfad nicht mehr als harte Blockade ausgewertet. Stattdessen fiel die Verarbeitung auf eine generische Benutzerabfrage zurück.
Das ist ein signifikanter Unterschied. ([Adversa AI][7])
28. Der bessere Parser existierte bereits
Interessant wird es noch an einer anderen Stelle.
Im Code existierte bereits ein neuerer Parser auf Basis von tree-sitter.
Dieser prüfte Deny-Regeln anders und korrekt auch im Kontext komplexer Kommandos, bevor auf den Fallback zurückgegangen wurde.
Der sicherere Mechanismus war also bereits implementiert.
Er war nur nicht in dem öffentlichen Legacy-Codepfad aktiv, den Kunden verwendeten. ([Adversa AI][7])
Der Fehler wurde später in Claude Code korrigiert.
Für mich ist dieser Bug ein wunderbares Beispiel dafür, dass viele Security-Annahmen künftig neu bewertet werden müssen.
29. Agenten brechen menschliche Annahmen
Menschen haben natürliche Grenzen.
Agenten nicht in gleicher Weise.
Ein Mensch:
- schreibt selten 50 Commands in eine Zeile
- probiert nicht 30 Exploitvarianten in wenigen Sekunden
- liest nicht hunderte Konfigurationsdateien in Minuten
- erzeugt nicht permanent neue Skripte
Ein Agent kann all das.
Damit werden Schwellenwerte, die früher „unrealistisches Benutzerverhalten“ beschrieben haben, plötzlich völlig normal.
Das betrifft:
- Rate Limits
- Detection Thresholds
- API Limits
- Permission-Systeme
- Review-Prozesse
- Anomalieerkennung
Wir müssen anfangen, Security Controls auch gegen maschinengetriebene Benutzeraktivität zu testen.
30. Phase 6 – Exfiltration und Persistenz
Mit zunehmendem Zugriff ging es nicht mehr nur um Exploitation.
Der Operator begann, die kompromittierten Umgebungen dauerhaft nutzbar zu machen.
Gambit berichtet insgesamt von einer Kampagne gegen neun mexikanische Regierungsorganisationen und der Exfiltration sehr großer Mengen personenbezogener Informationen. ([Gambit Security][1])
Die ursprüngliche Analyse nennt rund 150 GB Daten.
Betroffen waren je nach Organisation unter anderem:
- Steuerinformationen
- Identitätsdaten
- Wählerdaten
- Zugangsdaten
- Verwaltungsinformationen
- Gesundheitsdaten
- Zivilregisterinformationen
Bei den öffentlich genannten Zahlen sollte man etwas vorsichtig sein.
„Datensatz“ bedeutet nicht automatisch „eindeutige Person“.
Mehrere Systeme können dieselbe Person mehrfach enthalten.
Die Größenordnung ist trotzdem erheblich.
31. Persistenz nicht nur über Malware denken
In der ursprünglichen Untersuchung finden sich mehrere Arten persistenter beziehungsweise dauerhafter Zugriffe.
Dazu gehörten unter anderem:
- geplante Aufgaben
- Schlüssel beziehungsweise Credentials
- kompromittierte Management-Systeme
- Tunnel
- dauerhafte Datenbankzugänge
- Teile der Virtualisierungsinfrastruktur
Gerade für Incident Responder ist das wichtig.
Wenn ein Angreifer über Wochen in einer Umgebung aktiv war, reicht es nicht, den ursprünglichen Exploit zu patchen.
Die Frage ist danach:
Welche neuen Vertrauensbeziehungen hat er geschaffen?
32. Was ein IR-Team nach Initial Access rekonstruieren muss
Ich würde bei einem solchen Fall mindestens folgende Kette untersuchen:
Initial Access
     ↓
Credentials exposed?
     ↓
Where were they reused?
     ↓
Which systems were reachable?
     ↓
Management interfaces?
     ↓
Database access?
     ↓
Hypervisor?
     ↓
Scheduled tasks / cron?
     ↓
SSH keys / tokens?
     ↓
New tunnels?
     ↓
New external services?
Besonders problematisch sind dabei kompromittierte Management-Systeme.
Denn dort kann ein Angreifer mit einem einzigen Zugriff sehr viele weitere Systeme beeinflussen.
33. Exfiltration – nicht zu viel hineininterpretieren
Hier korrigiere ich bewusst einen Punkt aus meiner ursprünglichen Fassung.
Es gibt Hinweise auf:
- Tunneling
- Staging
- Archivierung
- Datenbankzugriffe
- automatisierte Sammlung
- Anti-Forensik
Was ich nicht als harten Fakt formulieren würde:
Die Archive wurden bewusst immer knapp unter typischen DLP-Schwellen gehalten.
Das ist plausibel.
Aber Plausibilität reicht mir für einen Fachartikel nicht.
Ebenso sollte man vorsichtig sein mit der Aussage, nach jeder Übertragung seien zwingend Logs bereinigt und Timestamps zurückgesetzt worden.
Anti-Forensik war Teil des Workflows.
Aber die Häufigkeit einzelner Maßnahmen sollte man nicht größer machen, als die Forensik belegt.
34. Hunting auf Sequenzen statt einzelne Tools
Aus dieser Phase würde ich deshalb nicht die Detection bauen:
alert if process == tar
Das wäre ziemlich nutzlos.
Interessanter wäre:
large file-read burst
   ↓
archive creation
   ↓
new outbound SSH connection
Oder:
DB client
   ↓
large query output to file
   ↓
compression
   ↓
external connection
Oder:
new scheduled task
   ↓
new SSH key
   ↓
rare destination
Detection Engineering lebt zunehmend von Sequenzen.
35. Die mexikanischen Behörden widersprechen
Am 25. beziehungsweise 26. Februar 2026 reagierten SAT und INE öffentlich auf die Berichte.
Das INE erklärte nach eigenen technischen Prüfungen, keine Sicherheitsverletzung, keine unautorisierten Zugriffe und keine Exfiltration in den fraglichen Zeiträumen festgestellt zu haben.
Auch SAT erklärte, bei der Prüfung relevanter Logs und Systeme keine unzulässigen Zugriffe oder auffälliges Verhalten erkannt zu haben. ([UnoTV][8])
Demgegenüber stehen die später von Gambit veröffentlichten forensischen Materialien.
Damit existiert ein erheblicher Widerspruch.
Mehr würde ich daraus aber nicht automatisch ableiten.
36. Warum ich „Vertuschung“ streichen würde
In meiner ursprünglichen Fassung war ich an dieser Stelle deutlich offensiver.
Begriffe wie:
Vertuschung
oder
institutionelles Versagen
sind mir für einen technischen Fachartikel inzwischen zu stark.
Wir wissen nicht:
- welchen Scope interne Untersuchungen hatten
- welche Systeme betrachtet wurden
- welche Log-Retention vorhanden war
- welche Zeiträume geprüft wurden
- welche Beweismittel intern vorlagen
- welche Informationen bewusst nicht öffentlich gemacht wurden
Was wir sagen können:
Die öffentlichen Aussagen der Behörden und die später veröffentlichten forensischen Ergebnisse von Gambit passen nicht ohne Weiteres zusammen.
Das ist Fakt genug.
37. Was sich bei Claude Code inzwischen geändert hat
Der Fall spielt Ende 2025 und Anfang 2026.
Claude Code von September 2026 ist nicht dasselbe Produkt.
Mehrere Sicherheitsmechanismen wurden verändert und zusätzliche Schutzebenen eingeführt.
Ein Beispiel ist Auto Mode.
38. Approval Fatigue ist real
Anthropic veröffentlichte im August 2026 interessante Zahlen aus der realen Claude-Code-Nutzung.
Nutzer genehmigten demnach ungefähr:
97 Prozent aller Permission Prompts.
Das Problem kann wahrscheinlich jeder nachvollziehen, der regelmäßig Sicherheitsdialoge sieht.
Irgendwann wird aus:
Bitte prüfen Sie sorgfältig.
praktisch:
Ja. Ja. Ja. Ja. Ja.
Anthropic stellte außerdem fest, dass 62 Prozent der Nutzer bereits bypassPermissions verwendet oder für Bash „don't ask again“ gewählt hatten. Ein Viertel interaktiver Sessions startete sogar direkt im Bypass-Permissions-Modus. ([Claude][4])
Human in the Loop klingt gut.
Aber nur solange der Human tatsächlich hinschaut.
39. Auto Mode
Anthropic führte deshalb Auto Mode ein und machte ihn im August 2026 für neue Sessions von Pro-, Max- und Team-Nutzern zum Standard, sofern keine abweichende Konfiguration gesetzt wurde. Enterprise und API-Nutzer waren zu diesem Zeitpunkt noch opt-in. ([Claude][4])
Dabei bewertet ein zusätzlicher Klassifikator Tool-Aktionen.
In einer kontrollierten Studie mit 1.053 bezahlten professionellen Testern erkannten menschliche Teilnehmer absichtlich eingefügte gefährliche Commands lediglich in 13,6 Prozent der Fälle.
Auto Mode blockierte 89 Prozent derselben Testbefehle.
Nach 50 oder mehr vorherigen Permission-Prompts sank die menschliche Erkennungsrate sogar auf rund fünf Prozent. ([Claude][4])
Das ist ein ziemlich gutes Beispiel für Approval Fatigue.
40. 89 Prozent ist keine allgemeine Sicherheitsquote
Diese Zahl sollte man trotzdem nicht falsch lesen.
89 Prozent bedeutet nicht:
Auto Mode schützt vor 89 Prozent aller Angriffe.
Der Test fand in einer kontrollierten Umgebung mit definierten gefährlichen Commands statt.
Anthropic weist selbst darauf hin, dass Auto Mode auf Klassifikationssystemen basiert und Risiko reduziert, aber nicht eliminiert. Für kritische Produktionsänderungen empfiehlt das Unternehmen weiterhin menschliche Prüfung. ([Claude][4])
Das ist eine wichtige Unterscheidung.
41. Rehberger zeigt die Grenzen
Ende August 2026 demonstrierte Johann Rehberger eine interessante indirekte Prompt-Injection-Kette gegen Claude Code mit Opus 5 im Auto Mode.
Der Ausgangspunkt war banal:
Claude sollte eine Webseite zusammenfassen.
Über eine Folge von Fehlern und Entscheidungen kam das System dazu, Inhalte anders abzurufen, ein Archiv herunterzuladen und schließlich einen selbst geschriebenen Decoder auszuführen.
Durch Python Module Shadowing konnte dabei attacker-controlled Code geladen werden.
Rehberger testete drei Varianten jeweils fünfmal.
Die Erfolgsraten lagen zwischen 60 und 80 Prozent.
Er betonte selbst, dass dies nur kleine Stichproben waren und keine allgemeine Bypass-Wahrscheinlichkeit darstellen. ([theregister][9])
Für mich ist die eigentliche Erkenntnis deshalb eine andere.
Ein Klassifikator ist keine harte technische Security Boundary.
42. Die echte Grenze muss technisch sein
Es gibt mehrere Schichten.
Model Guardrails
Das Modell entscheidet, ob es eine Aufgabe unterstützen möchte.
Prompt-Injection Detection
Ein System versucht, manipulative Instruktionen in fremdem Content zu erkennen.
Agent Permissions
Die Plattform legt fest, welche Tools erlaubt sind.
Classifier
Ein weiteres Modell bewertet Tool-Aufrufe.
Sandbox
Das Betriebssystem begrenzt technisch, was ein Prozess tun kann.
IAM
Die Identität begrenzt den Zugriff auf Ressourcen.
Network Control
Firewall und Egress-Regeln begrenzen Kommunikation.
Die oberen Ebenen sind hilfreich.
Aber die unteren Ebenen sind die, denen ich im Incident vertrauen möchte.
Oder kürzer:
Eine KI, die sagt „Das darf ich nicht“, ist keine Firewall.
43. Zwei klassische Claude-Code-CVEs zeigen das Problem
Auch Coding Agents bleiben ganz normale Software.
Und ganz normale Software hat Schwachstellen.
CVE-2025-59536
Claude Code konnte unter bestimmten Bedingungen Code aus einem nicht vertrauenswürdigen Projekt ausführen, bevor der Nutzer den Startup-Trust-Dialog bestätigt hatte.
Betroffen waren Versionen vor:
1.0.111
GitHub bewertet die Schwachstelle mit CVSS 8.7 High. ([GitHub][10])
Das ist keine philosophische AI-Safety-Frage.
Das ist klassische Code Execution.
CVE-2026-21852
Bei einer weiteren Schwachstelle konnte ein bösartiges Repository eine manipulierte:
ANTHROPIC_BASE_URL
in der Projektkonfiguration hinterlegen.
Claude Code verarbeitete diese Konfiguration vor Abschluss der Trust-Bestätigung und konnte dadurch API-Anfragen an einen attacker-controlled Endpoint senden.
Dabei konnten unter anderem Anthropic API Keys abfließen.
Betroffen waren Versionen vor:
2.0.65
Die Schwachstelle wurde mit CVSS 5.3 Moderate bewertet. ([GitHub][11])
Auch hier:
Keine magische AI-Schwachstelle.
Ein klassischer Trust-Boundary-Fehler.
44. Was Threat Hunter konkret aus diesem Fall lernen können
Für mich ergeben sich aus dem Fall mehrere neue beziehungsweise verstärkte Hunting-Hypothesen.
Diese sind Ableitungen aus dem Incident, keine veröffentlichten IOCs.
1. Agent-Prozesse sichtbar machen
Wir sollten wissen, wo Coding Agents laufen.
Und anschließend deren Child Processes sehen können.
Interessant sind Beziehungen wie:
claude
 ├─ bash
 ├─ python
 ├─ ssh
 ├─ curl
 ├─ git
 └─ database client
Das ist nicht automatisch bösartig.
Aber es liefert Kontext.
2. Agent-Konfigurationsänderungen überwachen
Besonders:
CLAUDE.md
.claude/settings.json
AGENTS.md
MCP configs
Hooks
Skills
Wenn solche Dateien unmittelbar vor ungewöhnlichen Aktionen verändert werden, ist das relevant.
3. Geschwindigkeit als Signal verwenden
Ein menschlicher Administrator und ein Agent können dieselben Commands ausführen.
Aber möglicherweise nicht mit derselben Geschwindigkeit.
Interessant werden:
- sehr viele Hosts in kurzer Zeit
- extrem schnelle Script-Revisionen
- wiederholte Tool-Erstellung
- unmittelbare Ausführung nach Erstellung
- schnelle Wechsel zwischen Recon, Exploit und Pivot
4. Kurzlebige Skripte erfassen
Ein AI-Agent kann schnell Wegwerfcode erzeugen.
Deshalb sind interessant:
create → execute → modify → execute → delete
innerhalb weniger Minuten.
Hash-only Detection hilft hier wenig.
5. Collection erkennen
Bevor Exfiltration kommt, muss häufig gesammelt werden.
Hunt auf:
- plötzlich große File-Read-Mengen
- zentrale Sammlung von Hostinformationen
- große Datenbank-Exports
- ungewöhnliche Archivierung
- massenhafte Konfigurationszugriffe
- zentrale Recon-Collector
45. Was Incident Responder konkret mitnehmen sollten
Der Fall ändert klassische IR nicht grundsätzlich.
Er macht sie zeitkritischer.
Nach Initial Access würde ich nicht nur fragen:
Wie kam der Angreifer rein?
Sondern sofort:
Was hätte ein Agent innerhalb der seitdem vergangenen Zeit bereits automatisiert erreichen können?
Das verändert die Scope-Analyse.
46. Sechs Stunden sind nicht mehr zwingend nur sechs Stunden
Wenn ein Angreifer sechs Stunden Zugriff hatte, muss ein Responder heute stärker berücksichtigen, dass in diesen sechs Stunden möglicherweise:
- hunderte Hosts enumeriert wurden
- mehrere Exploits angepasst wurden
- große Mengen Konfiguration analysiert wurden
- neue Tools entstanden
- Credentials automatisch geprüft wurden
- externe Reports generiert wurden
Zeit allein sagt also weniger über den potenziellen Scope aus.
Die Aktivitätsdichte wird wichtiger.
47. Die 20 CVEs sind vielleicht die wichtigste Zahl
Für mich bleibt eine der wichtigsten Erkenntnisse:
20 bekannte CVEs.
Das bedeutet nicht:
Patchen löst alle Security-Probleme.
Aber es bedeutet sehr wohl:
Klassische technische Hygiene bleibt extrem wirksam.
Gambit nennt selbst als grundlegende Gegenmaßnahmen:
- Patching
- Credential Rotation
- Network Segmentation
- Endpoint Detection
Die KI hat die zugrunde liegenden Schwachstellen nicht erschaffen. ([Gambit Security][1])
48. Vulnerability Management muss Geschwindigkeit stärker berücksichtigen
CVSS alleine reicht dafür schon lange nicht mehr.
Ich würde besonders betrachten:
- Internet Exposure
- vorhandener Exploit
- aktive Ausnutzung
- Asset Value
- Credentials auf dem System
- erreichbare Folgesysteme
- Privilege Escalation
- Segmentierung
- Detection Coverage
Ein internetseitiger CVSS-8-Server mit Zugang zu Management-Netzen kann operativ viel gefährlicher sein als ein CVSS-10-System in einer isolierten Laborumgebung.
49. Segmentierung bleibt langweilig und extrem effektiv
AI macht Netzwerksegmentierung nicht obsolet.
Im Gegenteil.
Wenn der Agent schnell erkennt, dass hinter dem ersten Server weitere interessante Systeme stehen, sollten diese Systeme technisch eben nicht automatisch erreichbar sein.
Besonders schützen würde ich:
- Domain Controller
- Hypervisor
- Backup-Infrastruktur
- IAM
- zentrale Management-Systeme
- Deployment-Systeme
- Datenbankadministration
- OT-/IoMT-Management
Initial Access sollte nicht automatisch zum Generalschlüssel werden.
50. Egress Control wird bei Agenten noch wichtiger
Agenten werden besonders mächtig, wenn sie frei ins Internet kommunizieren dürfen.
Dann können sie:
- Dokumentation abrufen
- Repositories lesen
- Pakete laden
- externe APIs ansprechen
- Tools herunterladen
- Daten übertragen
Deshalb ist Egress Control bei Agentic AI für mich eine der wichtigsten technischen Grenzen.
Nicht jeder Agent braucht freien Internetzugriff.
Nicht jeder Developer-Prozess braucht Zugriff auf jedes Ziel.
Was nicht benötigt wird, sollte technisch nicht möglich sein.
51. Credentials gehören nicht einfach in die Agentenumgebung
Ein Coding Agent läuft häufig im normalen Benutzerkontext.
Damit kann er potenziell sehen:
- SSH Keys
- Git Tokens
- Cloud Credentials
- Kubernetes-Konfigurationen
- Datenbankpasswörter
- API Keys
- lokale Secrets
Die relevante Frage lautet deshalb:
Warum sollte ein Agent alles sehen dürfen, was sein Benutzer sehen darf?
Least Privilege gilt auch für AI.
Eigentlich gerade dort.
Sinnvoll werden deshalb Konzepte wie:
- separate Agent Identities
- kurzlebige Tokens
- scoped Credentials
- isolierte Secret Stores
- minimale Berechtigungen
52. Der Fall ist keine Geschichte über eine böse KI
Je länger ich mir diesen Angriff anschaue, desto weniger sehe ich darin eine Story über eine außer Kontrolle geratene künstliche Intelligenz.
Es ist eine Story über Leverage.
Ein einzelner Operator konnte Tätigkeiten abdecken, für die traditionell mehrere Fähigkeiten notwendig sind:
- Reconnaissance
- Exploit Development
- Debugging
- Scripting
- Network Analysis
- Credential Analysis
- Datenbankanalyse
- Intelligence Processing
- Dokumentation
- Priorisierung
Er musste deshalb nicht in jeder Disziplin der beste Spezialist sein.
Er musste ausreichend verstehen, um das Ergebnis zu bewerten und den nächsten Schritt festzulegen.
53. Die Technik ist erstaunlich klassisch
Und trotzdem bleiben die Grundlagen dieselben.
Bekannte CVEs.
Credentials.
Erreichbare Systeme.
Netzwerkpfade.
Management Interfaces.
Fehlende Isolation.
Persistenz.
Datenzugriffe.
Das sind keine neuen Konzepte.
AI ändert vor allem:
Geschwindigkeit.
Skalierung.
Kosten.
Arbeitsaufwand pro Ziel.
54. Mein Fazit
Die vielleicht interessanteste Sequenz des gesamten Falls dauert nicht sieben Wochen.
Sie dauert neun Minuten.
03:34 UTC.
Vulnerability Scan.
Zwei Minuten später Remote Code Execution.
Dann sieben Minuten Debugging.
Acht Revisionen.
Am Ende steht ein angepasster Exploit.
Das ist für mich die eigentliche Geschichte.
Nicht weil kein Mensch das hätte tun können.
Natürlich hätte ein guter Pentester oder Angreifer das ebenfalls geschafft.
Aber wahrscheinlich nicht gleichzeitig auf dieselbe Weise, mit derselben Beharrlichkeit und zu denselben Grenzkosten.
Und genau das setzt sich durch die gesamte Kampagne fort.
Ein Exploit wird zum Tool.
Das Tool wird zum Framework.
Das Framework verarbeitet hunderte Systeme.
Ein zweites Modell analysiert die Ergebnisse.
Die Ergebnisse steuern den nächsten Angriff.
Die Technik dahinter ist nicht Science-Fiction.
Sie ist erstaunlich normal.
Vielleicht ist genau das das Problem.
Es brauchte keine böse Super-KI.
Es brauchte einen Menschen, der wusste, welches Ergebnis er wollte – und Systeme, die ihm einen erheblichen Teil der Arbeit zwischen Idee und Umsetzung abnahmen.
Für uns auf der anderen Seite bedeutet das nicht, dass alles, was wir über Cyber Defense gelernt haben, plötzlich wertlos ist.
Im Gegenteil.
Patchen funktioniert noch.
Segmentierung funktioniert noch.
Least Privilege funktioniert noch.
EDR funktioniert noch.
Egress Filtering funktioniert noch.
Threat Hunting funktioniert noch.
Incident Response funktioniert noch.
Aber wir sollten davon ausgehen, dass ein Gegner dieselben Fehler künftig schneller finden, analysieren und miteinander verbinden kann.
Die Antwort darauf ist deshalb nicht nur mehr AI auf der Verteidigerseite.
Die Antwort ist auch:
weniger unnötige Angriffsfläche, weniger implizites Vertrauen, schnellere Detection und vor allem weniger Zeit zwischen Erkenntnis und Reaktion.
Denn wenn der Gegner seine Schleife auf Minuten reduziert, können wir uns auf der Verteidigerseite keine Schleifen von Tagen mehr leisten.
Quellen
[1] Gambit Security – A Single Operator, Two AI Platforms, Nine Government Agencies: The Full Technical Report Eyal Sela, 10. April 2026. Zentrale Primärquelle für Kampagnenzeitraum, 75 Prozent AI-generierte Remote-Aktivität, 17.550-Zeilen-Python-Tool, 2.597 Reports, 305 Server, 400+ Angriffsskripte, 20 CVE-Exploits, 1.088 Prompts, 5.317 Commands und 34 Sessions. https://gambit.security/blog-posts/a-single-operator-two-ai-platforms-nine-government-agencies-the-full-technical-report
[2] SecurityWeek / Dragos – Claude AI Guided Hackers Toward OT Assets During Water Utility Intrusion
7. Mai 2026. Zentrale Quelle für die OT-Analyse, BACKUPOSINT v9.0 APEX PREDATOR, 49 Module, die selbstständige Erkennung der vNode-SCADA-/IIoT-Komponente sowie die zwei erfolglosen Password-Spray-Runden.
https://www.securityweek.com/claude-ai-guided-hackers-toward-ot-assets-during-water-utility-intrusion/
[3] AuthorityGate – One Operator, Two AI Platforms, Nine Mexican Government Agencies Breached Technische Rekonstruktion des Gambit-Berichts. Quelle für die zeitlichen Detailabläufe rund um die SAT-Session, 40 Minuten Refusal bis Live-System, 285-Zeilen-Exploit, acht Revisionen in sieben Minuten, 254 Prompts beziehungsweise rund 2.500 Remote Commands bei SAT sowie die 594-Zeilen-Flask-API. https://authoritygate.com/newsletter/mexico-government-breach-claude-code-gpt/
[4] The Weather Report – What Claude and GPT actually did in the Mexico government breach 21. April 2026. Ergänzende Rekonstruktion der SAT-Timeline mit 27. Dezember 2025, 03:34 UTC, RCE ungefähr zwei Minuten später und acht Payload-Iterationen innerhalb der folgenden sieben Minuten. https://theweatherreport.ai/posts/gambit-security-mexico-hack/
[5] Adversa AI – Critical Claude Code vulnerability: Deny rules silently bypassed because security checks cost too many tokens
2. April 2026. Technische Analyse des MAX_SUBCOMMANDS_FOR_SECURITY_CHECK = 50-Problems, bashPermissions.ts, Legacy-Parser und tree-sitter-Codepfad.
https://adversa.ai/blog/critical-claude-code-vulnerability-deny-rules-silently-bypassed-because-security-checks-cost-too-many-tokens/
[6] Anthropic – Auto mode is now the default in Claude Code for Pro, Max, and Team plans August 2026. Primärquelle für Auto Mode, 97 Prozent Permission-Approval-Rate, Studie mit 1.053 Testern, 13,6 Prozent menschliche Erkennung gegenüber 89 Prozent Auto Mode und weitere Nutzungsdaten zu Allow-/Bypass-Regeln. https://claude.com/blog/auto-mode-default-in-claude-code
[7] GitHub / Anthropic Security Advisory – CVE-2025-59536 / GHSA-4fgq-fpq9-mr3g Pre-Trust Code Execution in Claude Code. Betroffen vor Version 1.0.111, CVSS 8.7 High. https://github.com/anthropics/claude-code/security/advisories/GHSA-4fgq-fpq9-mr3g
[8] GitHub / Anthropic Security Advisory – CVE-2026-21852 / GHSA-jh7p-qr78-84p7
Pre-Trust-Datenabfluss über manipulierte ANTHROPIC_BASE_URL. Betroffen vor Version 2.0.65, CVSS 5.3 Moderate.
https://github.com/anthropics/claude-code/security/advisories/GHSA-jh7p-qr78-84p7
[9] The Register – Researcher shows how Claude Code can be tricked simply by asking it to summarize a website 28. August 2026. Bericht über Johann Rehbergers Tests gegen Claude Code mit Opus 5 im Auto Mode, Python Module Shadowing und die kleinen Testreihen mit beobachteten Erfolgsraten zwischen 60 und 80 Prozent. https://www.theregister.com/research/2026/08/28/researcher-shows-how-claude-code-can-be-tricked-simply-by-asking-it-to-summarize-a-website/5293372
[10] UnoTV – Tras alerta de hackeo, INE y SAT aseguran que su información no fue comprometida 26. Februar 2026. Quelle für die öffentlichen Stellungnahmen von INE und SAT. https://www.unotv.com/nacional/tras-alerta-de-hackeo-ine-y-sat-aseguran-que-su-informacion-no-fue-comprometida/
[11] Unit 42 – Attackers Expose Ongoing AI Tool Use Targeting Organizations in Latin America September 2026. Hilfreich zur Abgrenzung späterer AI-gestützter Aktivitäten und der von CloudSEK als Operation Escaneo beschriebenen Kampagne von Gambits ursprünglicher Untersuchung. https://unit42.paloaltonetworks.com/ai-tool-use-targeting-latam-orgs/